

Uma mesa de risco usa o beta para calcular o custo de capital próprio num modelo de precificação de ativos (CAPM), dimensionar um hedge de índice contra uma posição comprada, ou decompor o risco de uma carteira entre parcela sistemática e idiossincrática, e o número mais à mão costuma ser o beta bruto, o coeficiente angular de uma regressão de mínimos quadrados ordinários (MQO) do retorno da ação contra o mercado. Para uma ação pouco negociada, mesmo com os três anos completos de histórico usados neste artigo, cerca de 150 observações semanais, o erro-padrão da regressão ainda pode ser grande, porque a volatilidade do retorno idiossincrático domina o sinal sistemático, e esse erro-padrão já avisa que a estimativa pode estar longe do valor que vai se realizar no ano seguinte. Usar o beta bruto como se fosse exato é ignorar esse aviso. Descartá-lo e assumir beta igual a 1 para todo mundo joga fora a única informação específica daquela ação disponível. Mas mesmo depois de escolher uma correção, uma fatia grande do erro que sobra contra o resultado realizado continua lá, e esse artigo testa de onde ela vem.
O mercado resolve esse dilema há décadas com dois atalhos. O primeiro, atribuído a Marshall Blume, contrai o beta estimado na direção de 1 usando um peso fixo, a fórmula que o terminal Bloomberg aplica por padrão a qualquer beta que ele reporta (BLUME, 1971). O segundo, de Oldrich Vasicek, pondera o beta de cada ação pela precisão da própria estimativa antes de combiná-lo com a média do mercado (VASICEK, 1973). Os dois já são shrinkage, no sentido de que puxam uma estimativa ruidosa na direção de uma referência mais estável. Nenhum dos dois, porém, explica por que o peso deveria ser 2/3 e não 1/2, ou de onde vem a fórmula de ponderação por precisão usada por Vasicek. A atuária resolveu exatamente essa pergunta poucos anos antes de Blume publicar seu ajuste, dentro de um problema que parece distante de finanças: quanto confiar na sinistralidade própria de um segurado, contra a sinistralidade de toda a carteira de segurados semelhantes.
Este artigo abre a série “Atuária para quants”, baseada no capítulo 8 de Modern Actuarial Risk Theory, de Kaas, Goovaerts, Dhaene e Denuit (KAAS et al., 2008). Cada parte pega uma ferramenta da caixa atuarial e testa se ela ainda tem alguma coisa a ensinar a quem lida com carteiras, crédito e risco de mercado. Esta primeira parte aplica a credibilidade de Bühlmann-Straub ao beta de ações da B3, mostra que Blume e Vasicek já são, cada um à sua maneira, um caso particular da mesma fórmula atuarial, e que a própria fórmula de Bühlmann-Straub termina à frente das outras três, por uma margem pequena sobre a segunda colocada.
Uma ressalva organiza o resto do texto. Beta não serve para prever o retorno de uma ação. O que está em jogo aqui é a precificação de risco sistemático, para custo de capital, proporção de hedge e decomposição de risco de carteira. Em nenhum desses usos o analista quer saber se a ação vai subir ou descer. Quer saber o quanto ela se move, em média, junto com o mercado, e qual é a melhor estimativa desse número quando o beta estimado é pouco preciso, por causa da liquidez da ação ou da volatilidade do seu retorno idiossincrático.
Dois ajustes que o mercado já usa sem nomear credibilidade
Blume observou, numa amostra de ações americanas entre 1926 e 1968, que os betas estimados numa janela tendem a se aproximar de 1 na janela seguinte. Uma ação de beta 1,8 num período tende a mostrar um beta menor, embora ainda acima de 1, no período seguinte. Uma ação de beta 0,3 tende a subir. Blume não tratou isso como ruído a ignorar. Tratou como um padrão a incorporar na própria estimativa, propondo corrigir o beta bruto por uma combinação linear fixa com 1,0 (BLUME, 1971). A versão popularizada pelo mercado, usada por padrão pelo terminal Bloomberg no campo de beta ajustado, fixa os pesos em 2/3 para o beta bruto e 1/3 para 1,0, não importa a ação, o setor ou quantos anos de histórico ela tem (DAMODARAN, 1999):
Vasicek discordou de um ponto específico dessa fórmula. Por que usar o mesmo peso 2/3 para uma ação muito líquida, com um beta estimado com precisão alta, e para uma ação pouco negociada, cujo beta pode ter um erro-padrão três ou quatro vezes maior? Vasicek propôs ponderar cada beta individual pela própria precisão, medida pelo erro-padrão da regressão que o gerou, contra a dispersão de betas observada na seção transversal de todas as ações do período (VASICEK, 1973):
onde ŝei² é o erro-padrão ao quadrado do β̂ᵢ de MQO da própria ação, β̄ é a média simples dos betas estimados no período, e τ²_V é a variância dessa mesma amostra de betas. Uma ação com beta pouco preciso (ŝei² grande) recebe peso wᵢ baixo e seu beta é puxado com força na direção de β̄. Uma ação líquida, com beta preciso, mantém peso próximo de 1 e fica quase inalterada. A ideia já resolve a objeção central contra o peso fixo de Blume. Comparações diretas entre os dois ajustes já apareceram na literatura de finanças corporativas (LALLY, 1998), mas sem a moldura teórica que explica de onde vêm os pesos de cada um, e qual dos dois, se algum, está correto.
O debate não é só acadêmico nem estrangeiro. Uma dissertação de mestrado da USP sobre o setor elétrico brasileiro já discutia os dois ajustes e documentava a tendência de alta dos betas do setor a partir de 2005 (PINTO, 2008). Dez anos depois, o debate chegou à ANEEL. Numa audiência pública sobre a metodologia de custo de capital do setor elétrico, distribuidoras propuseram formalmente que o beta regulatório passasse a usar o ajuste de Blume, citando o costume do mercado como justificativa. A ANEEL rejeitou, argumentando que sair do modelo então vigente conferiria “mais discricionariedade ao processo” (ANEEL, 2019). Sem usar esse vocabulário, a objeção do regulador ecoa a crítica deste artigo ao peso fixo de Blume: a discricionariedade está em fixar Zᵢ = 2/3 sem nenhum critério ligado aos dados daquela ação. A instabilidade do beta estimado por MQO também está documentada diretamente no Brasil. Um estudo com as ações líquidas negociadas na B3 e na NYSE encontrou quebras estruturais relevantes na maioria dos setores das duas economias, e os betas reestimados depois de identificar essas quebras se aproximam de 1,0 em mais de 78% dos setores (OLIVEIRA; CUNHA, 2017).
A credibilidade de Bühlmann-Straub
A teoria da credibilidade nasceu dentro da tarifação de seguros, não de finanças. Uma seguradora de acidentes de trabalho precisa definir o prêmio de uma empresa cliente com poucos anos de sinistralidade própria. A experiência dessa empresa é a informação mais específica sobre o risco dela, embora poucos anos de sinistralidade pesem pouco sozinhos. A experiência de toda a carteira de empresas semelhantes é mais estável, embora ignore o que é próprio daquela empresa específica. Hans Bühlmann respondeu essa pergunta em 1967 com uma fórmula fechada (BÜHLMANN, 1967), estendida por Bühlmann e Erwin Straub em 1970 para carteiras com exposição desigual entre grupos, cada uma pesada por uma medida de quanta informação ela carrega (BÜHLMANN; STRAUB, 1970). Tratando cada ação i como um “grupo” e seu beta estimado β̂ᵢ como a “experiência própria”, a exposição natural é a precisão da própria estimativa, wᵢ = 1/Var(β̂ᵢ), o inverso do erro-padrão ao quadrado que a regressão de MQO já entrega:
wᵢ mede quanta informação a regressão da própria ação carrega sobre seu beta. Ações com beta impreciso (ŝeᵢ² grande) têm wᵢ baixo. σ̂² é a variância “dentro” (quanto o β̂ᵢ de uma ação oscilaria se fosse reestimado em amostras diferentes) e τ̂² é a variância “entre” ações (quanto os betas verdadeiros realmente diferem de uma ação para outra, livre do ruído de estimação). μ̂₀ é a média coletiva, a referência para a qual Zᵢ puxa o beta individual. Como wᵢ já é definido a partir da variância de cada ação individualmente, Var(β̂ᵢ) = 1/wᵢ é exata, não estimada por pooling, e a variância “dentro” σ̂² fica igual a 1 por construção: não sobra heterogeneidade de precisão nenhuma para o pooling capturar, porque cada grupo já chega com sua própria precisão conhecida. Só τ̂² precisa ser estimado a partir dos dados, pelo estimador não paramétrico de momentos popularizado por Bühlmann e Gisler (BÜHLMANN; GISLER, 2005):
com β̄w a média dos betas ponderada por wᵢ e m o número de ações no corte. O truncamento em zero existe porque, em amostras pequenas, a subtração do ruído de estimação pode resultar negativa, caso em que o modelo assume heterogeneidade real nula entre ações e credibilidade zero para todas.
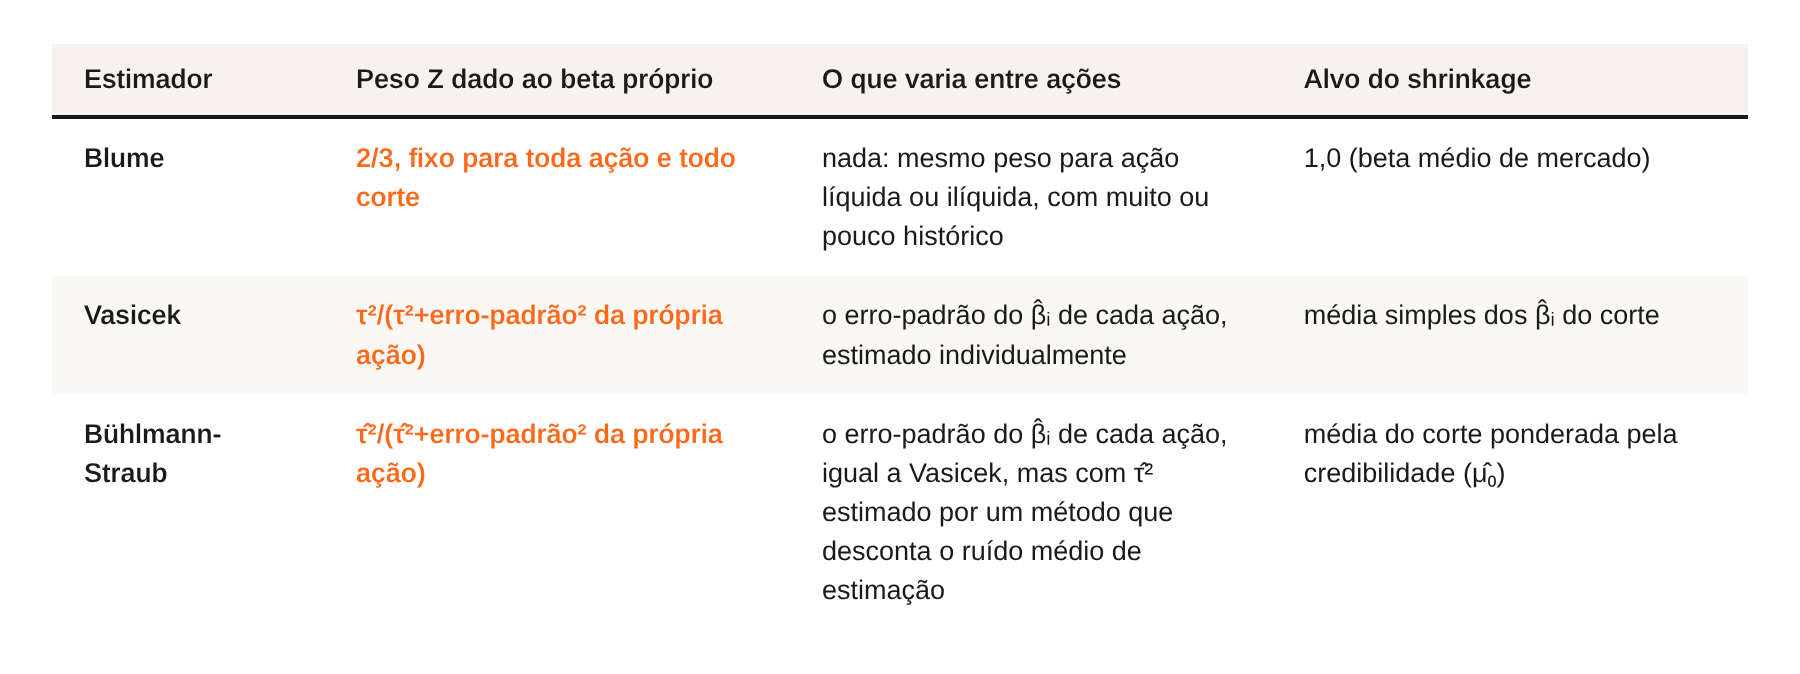
Blume e Vasicek são dois casos particulares dessa fórmula, cada um simplificando de um jeito diferente os dois passos de estimação.
Blume é credibilidade com Zᵢ fixo. Em vez de estimar Zᵢ = wᵢ/(wᵢ+κ̂) a partir da precisão e da variância entre ações, Blume fixa Zᵢ = 2/3 para toda ação e todo período, e fixa o alvo do shrinkage em 1,0 em vez de estimar a média coletiva μ̂₀ a partir dos dados. É credibilidade sem os dois passos de estimação, substituídos por uma constante calibrada décadas atrás, na mesma amostra de ações americanas entre 1926 e 1968 mencionada acima.
Vasicek é parente próximo de Bühlmann-Straub, não uma fórmula concorrente independente: os dois chegam à mesma forma funcional, Zᵢ = τ̂²/(τ̂²+ŝeᵢ²), ponderando cada beta pela precisão da própria estimativa contra a dispersão da população, relação que a literatura mais recente também formaliza (MEYER-BULLERDIEK, 2024). A diferença entre os dois está só em como τ̂² é estimado. Vasicek usa a variância amostral bruta dos β̂ᵢ, sem corrigir pelo ruído médio de estimação que infla essa variância. Bühlmann-Straub usa o estimador de momentos não paramétrico acima, que subtrai esse ruído antes de atribuir o resto à heterogeneidade real entre ações. Quando o ruído médio de estimação é pequeno relativo à dispersão real dos betas, as duas fórmulas convergem. Quando não é, elas discordam, e o restante deste artigo mede qual discordância importa mais nos dados.
Ações da B3 sem viés de sobrevivência
A B3 publica, nas séries históricas de cotações (COTAHIST), um registro diário de preço, volume e quantidade negociada para todo papel-mercado, organizado em arquivos anuais desde 2005. Esse arquivo não exige nenhum cadastro de ações atualmente listadas, condição importante para evitar viés de sobrevivência. O universo de cada ano-teste é construído só com o que o próprio COTAHIST daquele ano contém, sem filtrar pelo que ainda está listado hoje, de modo que ações hoje deslistadas entram na amostra nos anos em que efetivamente negociaram.
O filtro de elegibilidade restringe o universo a ações ordinárias e preferenciais simples (ESPECI igual a ON ou PN, excluindo classes preferenciais A a H e outros papéis-mercado), negociadas em lote padrão no mercado à vista (código BDI 02, tipo de mercado 010). Esse recorte produz, ao longo de 2005 a 2025, 964 tickers distintos com ao menos uma cotação válida.
O COTAHIST não ajusta preços retroativamente por desdobramentos, grupamentos ou bonificações. Um desdobramento 1:2 aparece como uma queda mecânica de 50% no preço de um pregão para o outro, sem relação com o retorno econômico do acionista. O código deste artigo detecta esses saltos comparando a razão de preço entre pregões consecutivos contra uma tabela de razões redondas plausíveis (desdobramentos e grupamentos de 1:2 a 1:10, bonificações de 5% a 100%), dentro de uma tolerância de 4%, e reescala retroativamente a série inteira quando encontra correspondência. Dois cuidados adicionais evitam falsos positivos. Primeiro, a detecção é vetada em dias de dispersão transversal anormalmente alta entre todas as ações (mercado em crise ou rali), porque um salto de 32% num único papel pode ser apenas um dia extremo de mercado, não um evento societário isolado. O caso real corrigido por essa regra foi CVCB3 em 26 de março de 2020, no auge da crise da Covid, cujo salto de preço de 32,4% coincidia por acaso com a razão de uma bonificação de 33%, mas ocorreu num dia em que a dispersão entre todas as ações já estava em 4,1 pontos percentuais, bem acima do piso de 2,5 pontos percentuais usado para vetar a detecção nesse tipo de dia. Segundo, abaixo de R$ 1 por ação o detector é desligado, porque ações a centavos oscilam 2x ou mais por puro ruído de tela, e essas ações já ficam fora da amostra de estimação pelo filtro de liquidez de qualquer forma. Dividendos em dinheiro não são somados de volta ao preço. O retorno usado é retorno de preço, não total return, a convenção mais comum para estimar beta, cuja diferença tende a ser pequena para a maior parte das ações líquidas e maior para as de alto dividend yield, uma limitação reconhecida explicitamente aqui.
Os retornos usados são semanais. Retorno diário carrega ruído de microestrutura (o efeito bid-ask, a não sincronia de negociação) que infla a variância idiossincrática sem acrescentar sinal sistemático. Retorno mensal, numa janela de treino de três anos, deixa poucas dezenas de observações por ação, pouco para estimar um erro-padrão individual com alguma estabilidade, insumo central tanto de Vasicek quanto de Bühlmann-Straub. Retorno semanal equilibra os dois lados, com cerca de 150 observações numa janela de três anos. A carteira de mercado é construída com os próprios dados do COTAHIST, igual-ponderada entre todas as ações elegíveis com retorno válido naquela semana. A B3 não publica, no arquivo de cotações, a quantidade de ações em circulação de cada papel, de modo que um índice ponderado por valor de mercado exigiria uma fonte de dados adicional. A igual-ponderação evita essa dependência e mantém o pipeline inteiro reproduzível a partir de uma única fonte pública, ao custo de produzir uma carteira de mercado com nível e composição diferentes dos do Ibovespa, que é ponderado por valor em free float.
O filtro de liquidez exige, na janela de treino de cada corte, pelo menos 26 semanas de retorno válido e volume financeiro semanal mediano de R$ 50 mil ou mais. O mesmo piso de 26 semanas se aplica à janela de teste, para que o beta realizado usado como alvo também tenha uma base mínima de observações. O código do pipeline, em Julia, processa diretamente os arquivos COTAHIST anuais publicados pela B3. O código está publicado no repositório pq_credibilidade_beta, no GitHub.
Desenho da avaliação
O beta de cada ação é estimado por MQO contra a carteira de mercado numa janela de treino de três anos, e avaliado contra o beta realizado da mesma ação na janela de teste de um ano imediatamente seguinte, sem sobreposição. O beta realizado usa exatamente a mesma regressão, só que calculada com os retornos do período de teste, que fica fora da etapa de estimação. O corte é repetido para todo ano-teste entre 2008 e 2025, 18 cortes completos, cada um usando os três anos de treino imediatamente anteriores. O agregado reportado adiante soma os 18 cortes completos, sem excluir nenhum deles por conveniência.
O beta realizado também é uma estimativa ruidosa, não a verdade. Ele vem de uma regressão sobre cerca de 52 semanas de teste, com seu próprio erro-padrão, discutido na próxima seção. Qualquer comparação entre um estimador de beta e o beta realizado carrega esse piso de ruído do alvo, que nenhum estimador, por melhor que seja, consegue eliminar.
A métrica de erro é a raiz do erro quadrático médio (RMSE), com o erro médio absoluto (MAE) reportado em paralelo, agregados (pooled) sobre todas as ações de todos os 18 cortes, não a média simples dos RMEs por corte. A significância das diferenças entre estimadores usa bootstrap pareado por ação dentro de cada corte, com 5.000 reamostras, preservando a correlação entre os quatro estimadores ao reamostrar os mesmos índices para todos eles em cada repetição, e bootstrap por bloco de ano, que reamostra quais dos 18 cortes entram em cada repetição mantendo cada corte inteiro, para não ignorar condições de mercado comuns a todas as ações no mesmo ano-teste.
O piso de ruído do alvo
O beta realizado usado como alvo não é a verdade sobre o risco sistemático de uma ação. É ele mesmo uma estimativa, com seu próprio erro de medição, pela mesma razão que o beta de treino tem: poucas dezenas ou centenas de observações semanais carregam ruído de amostragem em torno do parâmetro verdadeiro. Se o alvo contra o qual os quatro estimadores são julgados já carrega esse ruído, parte do erro medido entre estimativa e alvo não é falha de nenhum estimador. É ruído de medição do próprio alvo.
Para medir esse piso sem depender de um pressuposto sobre a forma do erro, as semanas de teste de cada ação foram divididas em duas metades, de duas formas. Semanas pares contra ímpares, intercaladas no tempo, isolam ruído de amostragem puro. Primeira metade do ano-teste contra segunda metade também captam deriva real do beta dentro do próprio ano, além do ruído de amostragem. A correção split-half clássica estabelece que a variância do ruído se aproxima de um quarto da variância da diferença entre as duas metades:
Pares e ímpares dão um desvio de ruído de 0,473. Primeira e segunda metade dão 0,495, um pouco mais alto porque a diferença entre essas duas metades também inclui deriva real do beta dentro do ano, além do ruído de amostragem puro. Uma checagem independente, que não depende de dividir nada em metades, soma o quadrado do erro-padrão de cada regressão de beta realizado ao longo dos 18 cortes e tira a raiz: 0,444, cerca de 12% abaixo das duas estimativas split-half, possivelmente porque a fórmula clássica de erro-padrão do MQO, que assume resíduos independentes e identicamente distribuídos, subestima um pouco o ruído real dos retornos semanais. As três estimativas, por métodos diferentes, convergem para a mesma faixa, entre 0,44 e 0,50 de desvio.
Esse piso entra na comparação porque o erro quadrático médio medido contra o alvo é, aproximadamente, a soma do erro quadrático médio que um estimador perfeito ainda exibiria por causa do ruído do próprio alvo com o erro quadrático médio que de fato reflete imprecisão do estimador:
Aplicando essa correção aos quatro estimadores testados aqui, usando a estimativa central split-half de pares e ímpares:
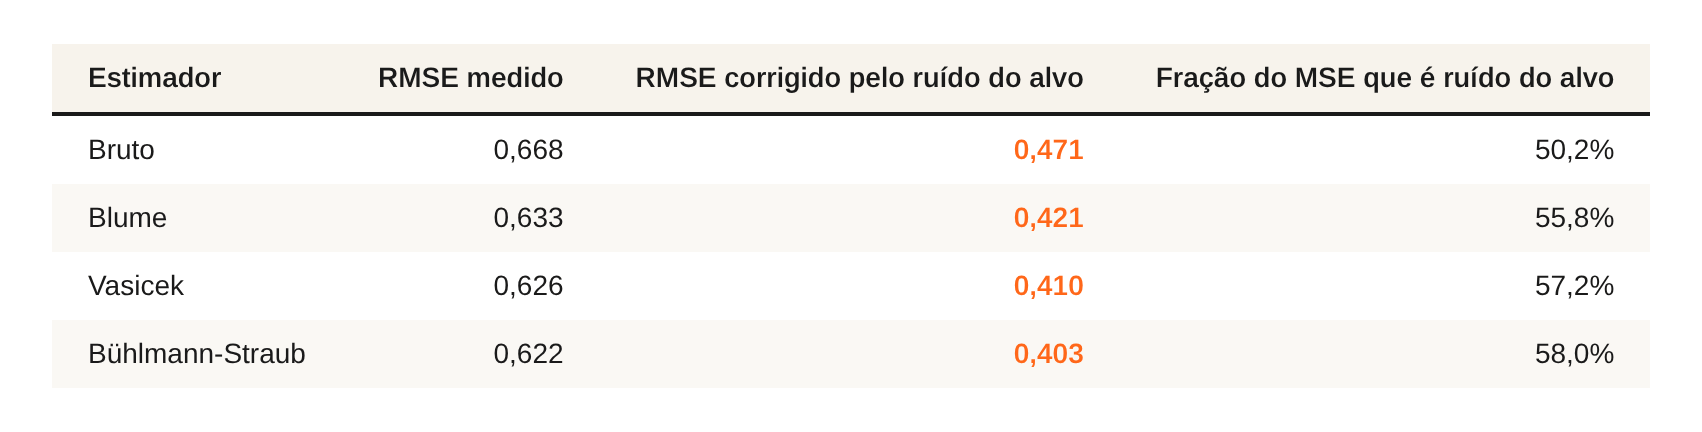
Entre 44% e 62% do erro quadrático medido, a depender do estimador e do método usado para estimar o ruído, é ruído de medição do próprio alvo contra o qual os quatro estimadores são comparados. A fração é um pouco maior para os três regularizados (entre 49% e 62%) do que para o bruto (entre 44% e 55%), porque o ruído do alvo é praticamente fixo entre estimadores, mas o erro total medido é menor para quem já erra menos, de modo que o mesmo numerador pesa proporcionalmente mais sobre um denominador menor. Essa é a explicação mais direta, nesta amostra, de por que os quatro erros reportados neste artigo parecem altos e parecidos entre si. Uma fração grande e comum aos quatro é piso de medição.
Resultados
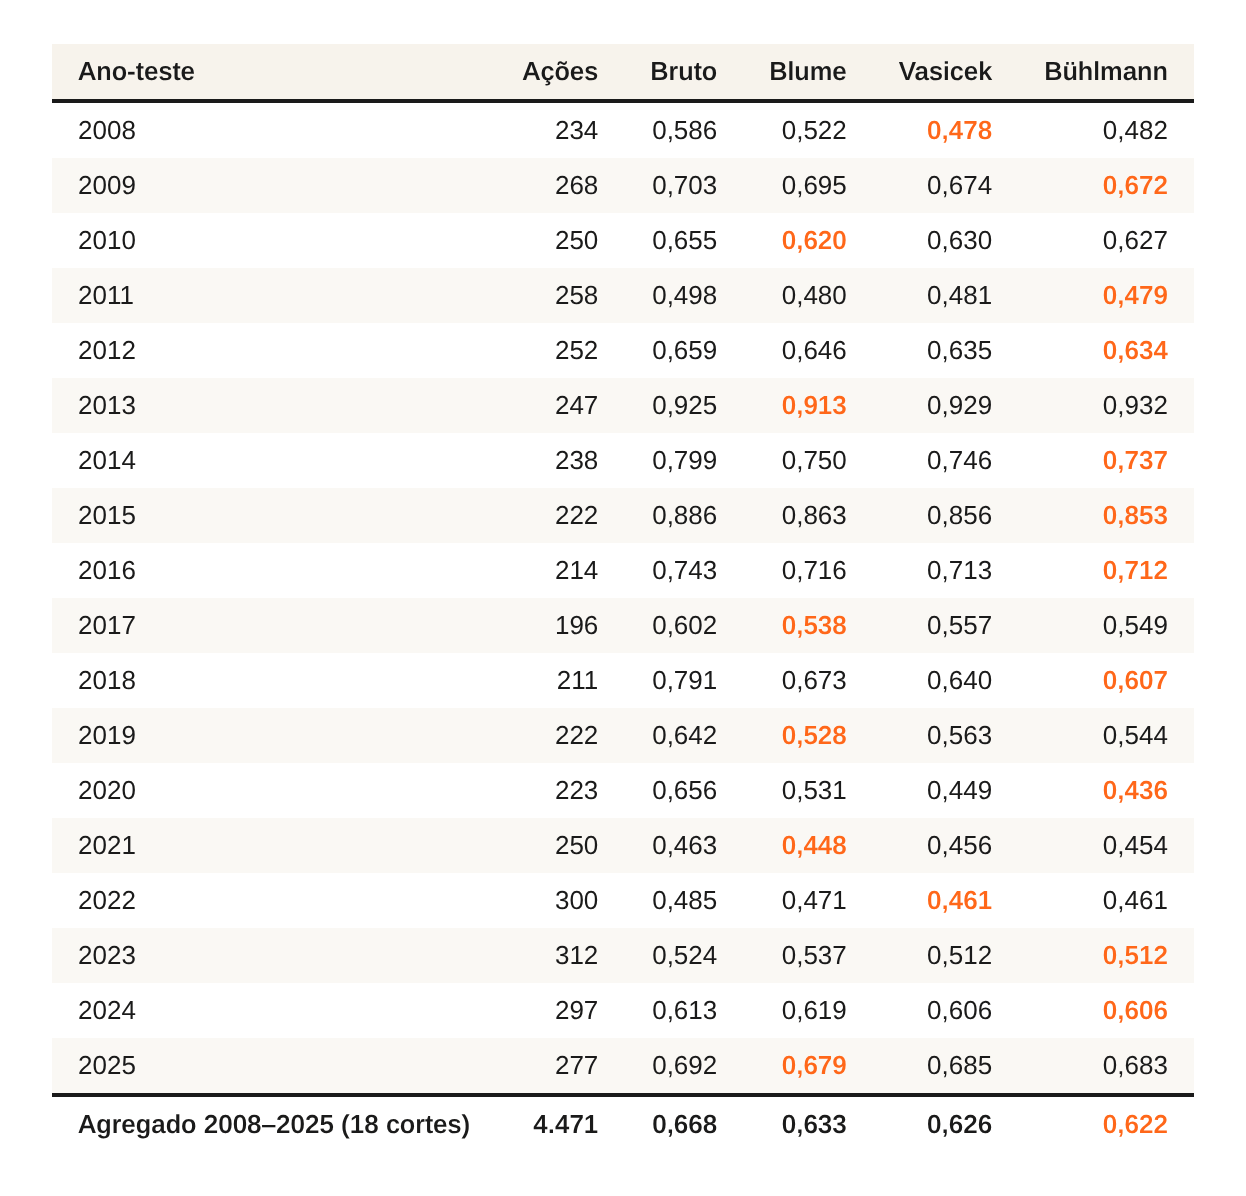
Nos 4.471 pares ação-ano reunidos pelos 18 cortes, com janela de treino de três anos, o RMSE agregado vai de 0,668 no beta bruto a 0,622 no melhor dos três regularizados (Bühlmann-Straub), passando por 0,633 (Blume) e 0,626 (Vasicek).
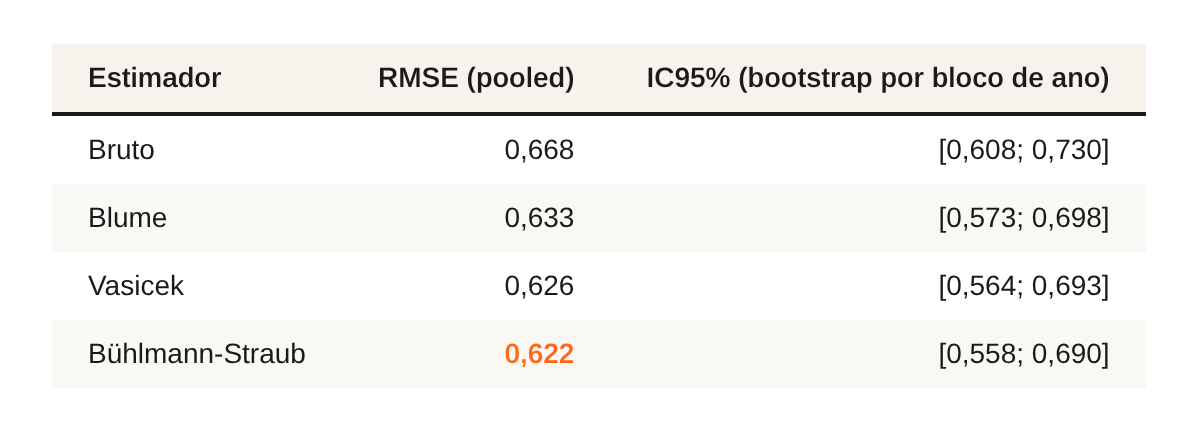
A referência de incerteza usada aqui é o bootstrap por bloco de ano, mais conservador que o bootstrap pareado por ação porque preserva a correlação entre ações dentro do mesmo ano-teste. O intervalo de confiança do RMSE de Bühlmann-Straub não encosta no intervalo de nenhum dos outros: a diferença RMSE(bruto) menos RMSE(Bühlmann-Straub) fica entre 0,024 e 0,074, RMSE(Blume) menos RMSE(Bühlmann-Straub) entre 0,002 e 0,024, e RMSE(Vasicek) menos RMSE(Bühlmann-Straub) entre 0,001 e 0,008, todas inteiramente acima de zero. A vantagem sobre Vasicek é a menor das três, mas ainda assim não cruza zero. Um bootstrap pareado por ação dentro de cada corte, mais otimista porque ignora a correlação entre ações do mesmo ano, encontra o mesmo padrão: [0,028; 0,067] contra o bruto, [0,002; 0,023] contra Blume e [0,002; 0,006] contra Vasicek.
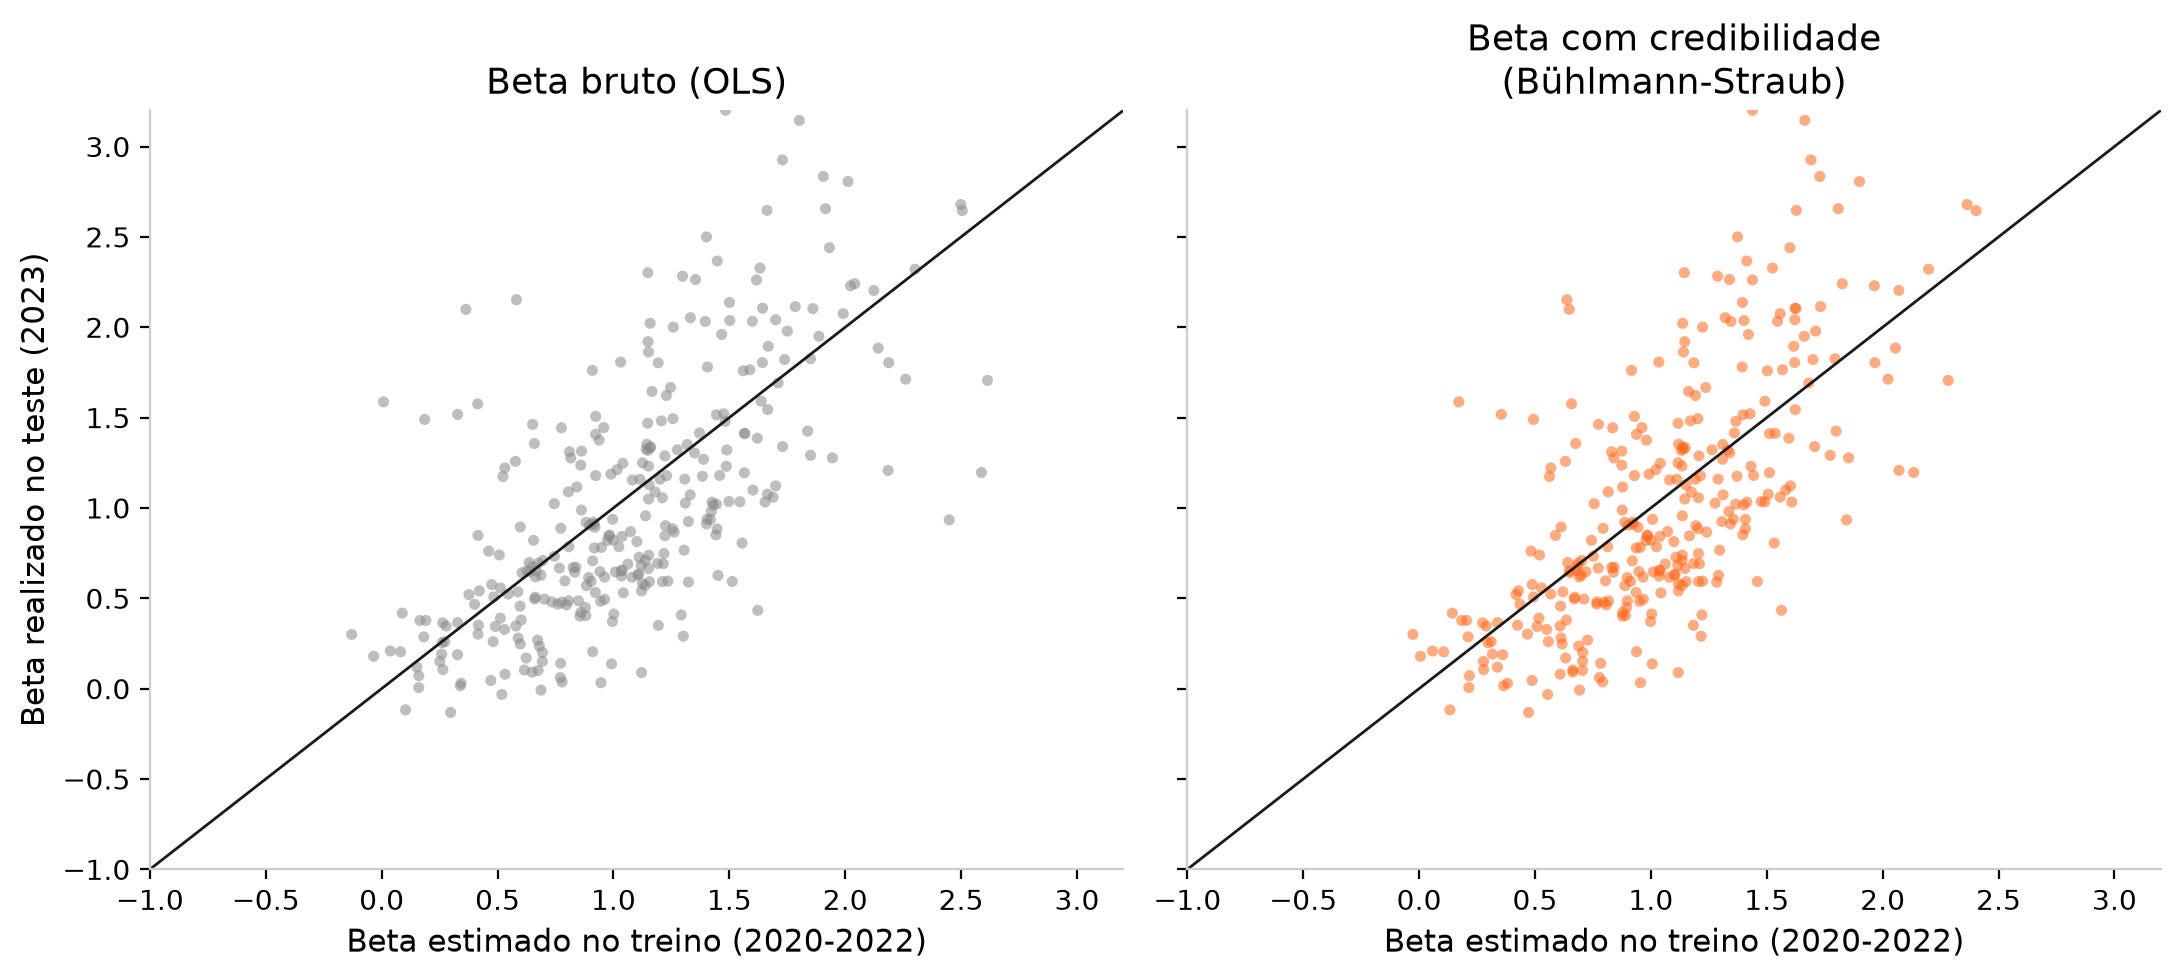
A tabela com os 18 cortes completos, sem nenhum recorte favorável, mostra que, nestes cortes, nenhum dos quatro estimadores vence em todos os anos: Bühlmann-Straub é o melhor em dez cortes, Blume em seis e Vasicek em dois, enquanto o beta bruto não vence em nenhum deles. A vitória de Bühlmann-Straub no agregado reflete uma vantagem pequena, mas espalhada pela maioria dos cortes, não um resultado dominado por um ou dois anos atípicos.
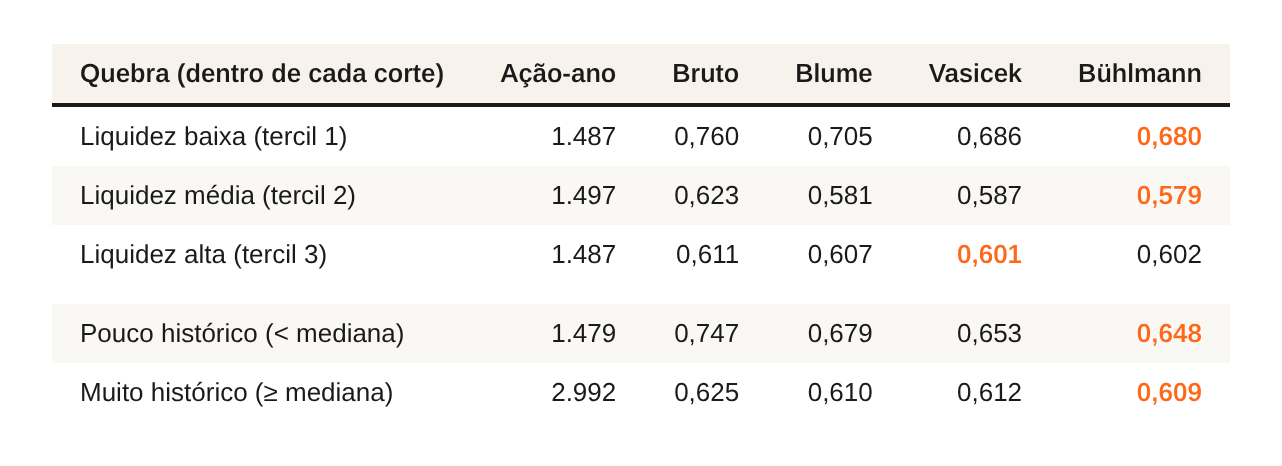
Separando a amostra por liquidez (tercis de volume financeiro semanal mediano na janela de treino, calculados dentro de cada corte), o ganho do shrinkage se concentra exatamente onde a teoria prevê que deveria se concentrar: na precisão do beta bruto. Com a janela de três anos usada neste artigo, o tamanho do histórico de treino disponível pesa pouco nessa precisão, porque a maior parte das ações já chega com histórico quase completo. A mediana de semanas de treino fica em 157, de um máximo de 158, e 987 dos 4.471 pares ação-ano (22%) têm menos de 90% das semanas possíveis. O que de fato diferencia a precisão do beta bruto de uma ação para outra é a liquidez e a volatilidade do retorno idiossincrático, os dois ingredientes do erro-padrão de cada beta. No tercil de liquidez mais baixa, o RMSE cai de 0,760 (bruto) para 0,680 (Bühlmann-Straub, o melhor ali), uma redução de 10,5%. No tercil de liquidez mais alta, a mesma comparação vai de 0,611 para 0,601 (Vasicek, o melhor nesse grupo), uma redução de 1,6%. Ações pouco líquidas são, ao mesmo tempo, as que têm o beta bruto mais ruidoso e as que mais se beneficiam de qualquer uma das três correções. A quebra por tamanho de histórico de treino aparece na tabela, para registro.
Prateleiras de liquidez, em mais detalhe
A quebra por tercil de liquidez já mostra que o ganho do shrinkage é maior onde a ação é menos negociada. Para ver com mais detalhe onde esse ganho se concentra, a mesma amostra foi dividida em cinco quintis de liquidez, calculados dentro de cada corte a partir só do volume financeiro semanal mediano na janela de treino, sem olhar o futuro. Uma mesma ação pode mudar de quintil de um corte para outro, conforme o volume negociado muda ao longo do tempo.

No quintil menos líquido (902 pares ação-ano, volume semanal mediano em torno de R$ 143 mil, exemplos como ALPA3, BGIP4 e WHRL4), o RMSE cai de 0,796 (bruto) para 0,705 (Bühlmann-Straub, o melhor ali), com o MAE caindo de 0,505 para 0,472. O intervalo de confiança por bloco de ano para a diferença RMSE(bruto) menos RMSE(Bühlmann-Straub) fica entre 0,032 e 0,177, inteiramente acima de zero, e o ganho sobre o erro redutível (a diferença entre o bruto e o piso de ruído do próprio alvo naquele quintil) chega a 57%. Esse ganho cai rápido conforme a liquidez sobe: 32% no segundo quintil, 18% no terceiro, 5% no quarto e 8% no quinto (R$ 358 milhões de volume mediano, exemplos como LREN3, GGBR4 e VALE3). Nos quintis 3, 4 e 5, pelo menos uma das duas comparações por bloco de ano (bruto contra Vasicek ou contra Bühlmann-Straub) tem o intervalo de confiança cruzando zero, de modo que a vantagem da regularização ali não se distingue de zero com a confiança usada neste artigo.
O Z médio de Bühlmann-Straub varia com a liquidez, de 0,756 no quintil menos líquido a 0,865 no mais líquido. Z depende da precisão de cada beta, que por sua vez depende da liquidez da ação e de quão volátil é seu retorno idiossincrático, não do tamanho do histórico de treino: com a janela de três anos usada aqui, a maior parte das ações já chega com histórico quase completo. Ações menos negociadas tendem a ter betas menos precisos, então a fórmula puxa mais peso para a média coletiva ali, e menos peso nas ações mais líquidas, cujo beta próprio já é preciso o bastante para pesar mais na estimativa final. A fração do MSE que é ruído do alvo também é maior no quintil menos líquido (64%) do que nos demais (41% a 52%), reforçando que ações pouco negociadas têm, ao mesmo tempo, o beta mais difícil de estimar e o beta realizado mais ruidoso como alvo de comparação.
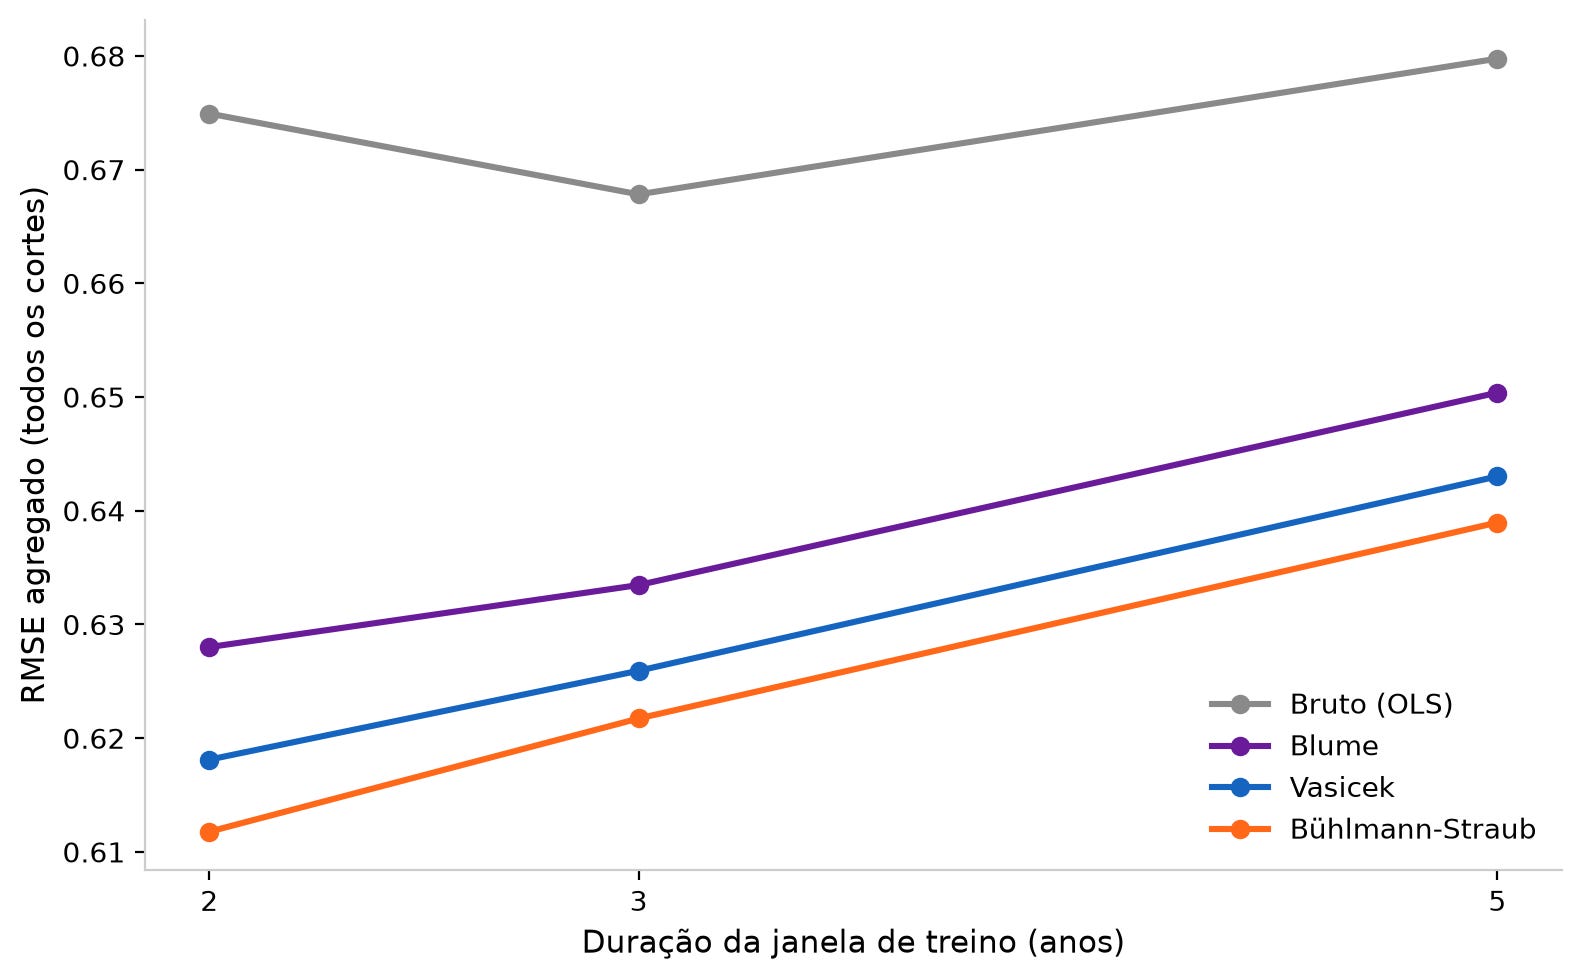
A janela de treino de três anos é uma escolha entre várias. Repetindo o exercício inteiro com janelas de dois anos (19 cortes, 2007-2025, 4.639 pares ação-ano) e de cinco anos (16 cortes, 2010-2025, 3.993 pares ação-ano), a ordem entre os quatro estimadores não muda. Na janela de dois anos, o RMSE agregado vai de 0,675 (bruto) a 0,612 (Bühlmann-Straub), passando por 0,628 (Blume) e 0,618 (Vasicek). Na janela de cinco anos, de 0,680 (bruto) a 0,639 (Bühlmann-Straub), com Blume em 0,650 e Vasicek em 0,643. O RMSE absoluto piora um pouco com janelas mais longas, provavelmente porque um beta de cinco anos atrás descreve pior o regime de risco do ano-teste do que um beta mais recente, mas a conclusão qualitativa (Bühlmann-Straub à frente, Vasicek em segundo, bruto atrás) se mantém nas três durações testadas.
O que mais foi testado, e não resolveu o piso
O piso de ruído do alvo levanta a pergunta óbvia: existe algum ajuste, além dos quatro estimadores já comparados, que reduza o erro restante por uma margem relevante? Cinco frentes adicionais foram testadas sobre o beta bruto, cada uma isolada das demais para separar o efeito de cada mudança.
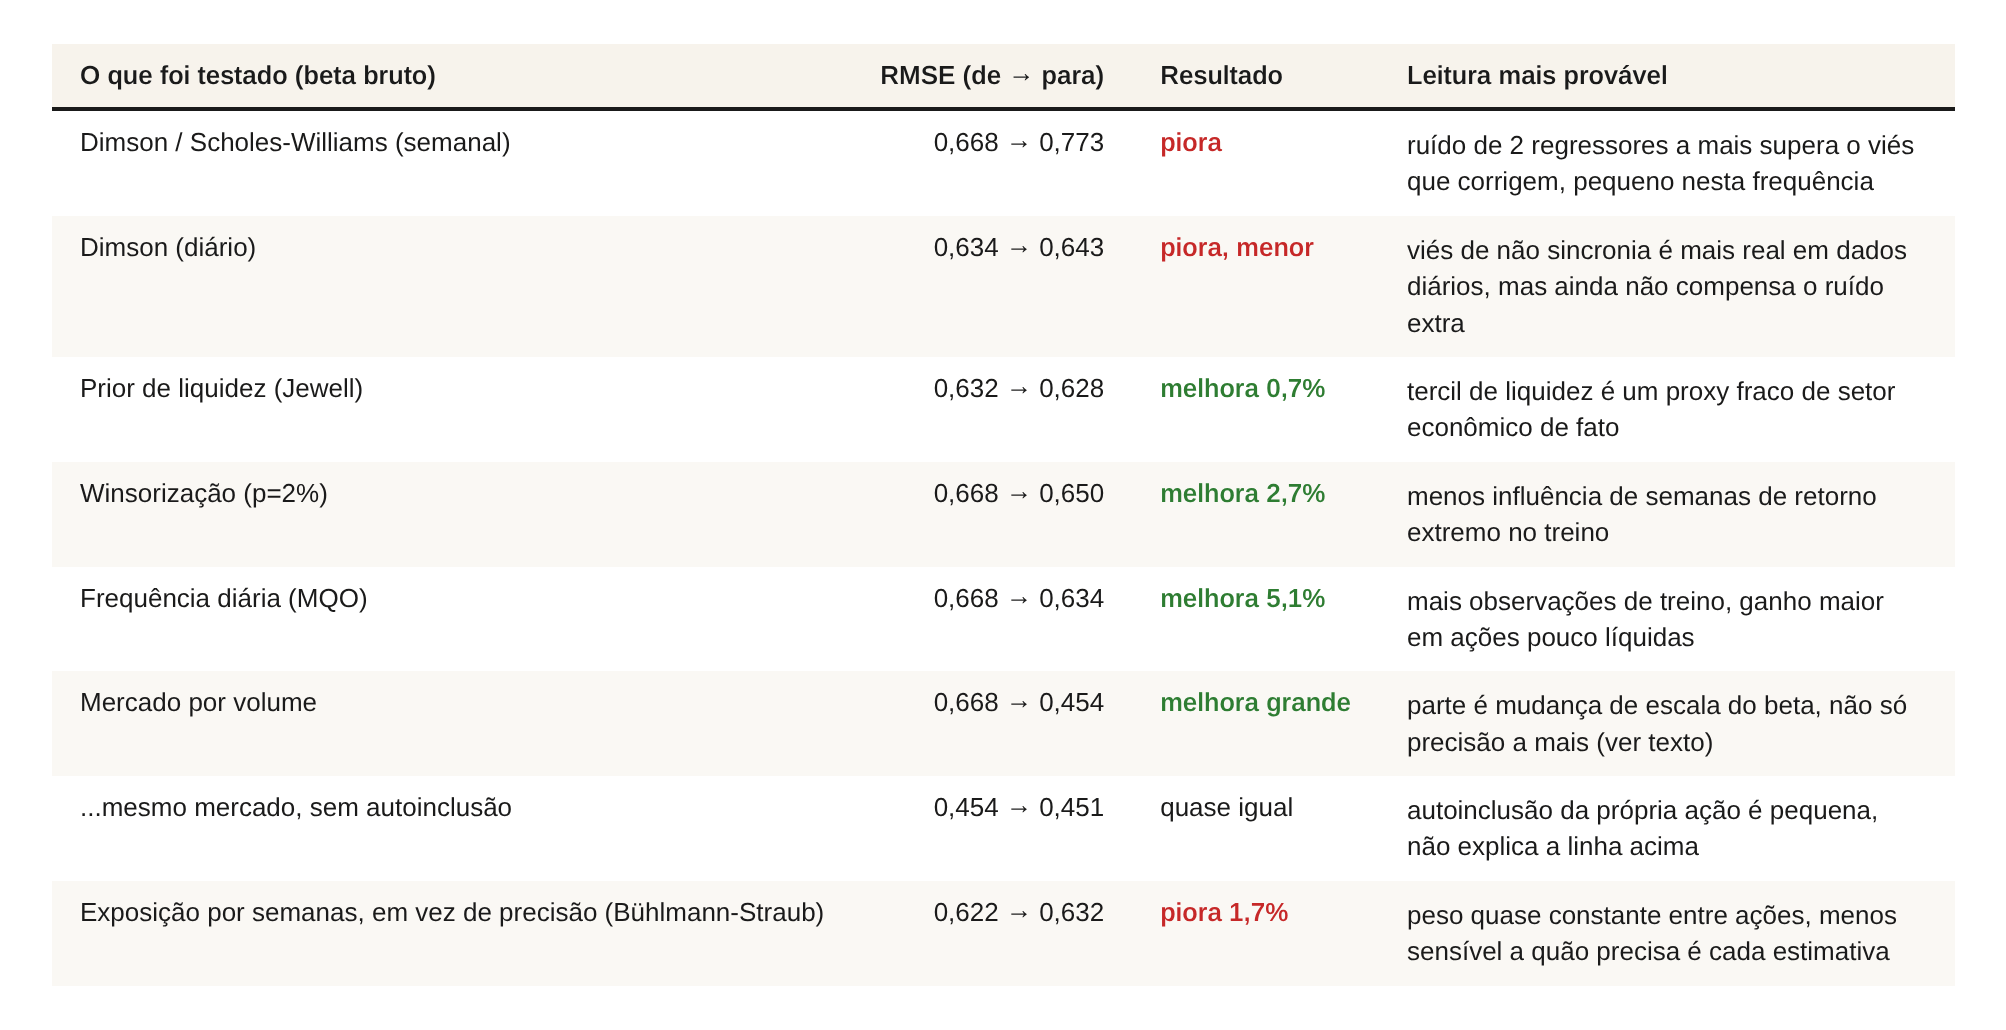
Duas correções clássicas para negociação não sincrônica, conhecidas como beta de Dimson e beta de Scholes-Williams, pioram o ajuste em dados semanais, a de Dimson piorando mais justamente no tercil de ações menos líquidas, onde a teoria previa que ajudaria mais. Em dados diários a piora é bem menor, consistente com a ideia de que a não sincronia pesa mais nessa frequência. Ainda assim, a correção não chega a virar melhora nesta amostra. Um prior de liquidez, usado como substituto aproximado de setor econômico porque a B3 não publica um arquivo de classificação setorial em lote, melhora pouco, porque tercil de liquidez é um proxy fraco de setor de fato. Winsorizar os retornos de treino no percentil 2% melhora um pouco, de forma barata e sem mudar a escala do beta. Usar o número de semanas como exposição em vez da precisão do beta, dentro do próprio Bühlmann-Straub, piora o RMSE de 0,622 para 0,632, porque o peso fica quase constante entre ações em vez de refletir quanta informação cada uma carrega.
Trocar a carteira de mercado igual-ponderada por uma ponderada por volume financeiro negociado, não por valor de mercado (o COTAHIST não traz ações em circulação para ponderar por capitalização), reduz bastante o RMSE em termos absolutos. Essa carteira concentra 27,5% do volume mediano em dez papéis, entre eles PETR4, ITUB4, B3SA3 e os principais bancos listados, o que muda a escala típica do beta (média 0,695 contra 1,074 sob a carteira igual-ponderada usada no restante deste artigo) e torna a comparação direta de RMSE entre as duas carteiras enganosa. Essa concentração levanta uma hipótese específica. Para os papéis mais negociados, o retorno da própria ação entra no cômputo do mercado contra o qual ela é regredida, o que poderia inflar mecanicamente a correlação medida. Recalculando o beta de cada ação com essa autoinclusão removida (leave-one-out, em forma fechada), o RMSE do mercado ponderado por volume melhora só entre 0,6% e 0,8% a mais, e a diferença de RMSE entre os dois mercados continua quase a mesma com ou sem autoinclusão (0,214 contra 0,208, no beta bruto). A autoinclusão é um viés real, na direção esperada, mas pequeno demais para explicar a diferença grande entre as duas carteiras de mercado. O que distingue as duas é composição e escala do fator.
Por que regularizar ajuda, mesmo com esse piso
Diante desses números, nesta amostra, os três estimadores regularizados (Blume, Vasicek e Bühlmann-Straub) batem o beta bruto nos 18 cortes completos e nos dois métodos de bootstrap usados aqui, com o tamanho da redução seguindo de perto a liquidez de cada ação: de 10,5% no tercil menos líquido a 1,6% no mais líquido. Isso sustenta regularizar o beta como padrão de uso nesta amostra, com o bruto reservado a casos em que a correção já teria pouco a corrigir: ação líquida, com beta já preciso, onde o peso dado ao beta próprio tende a 1 de qualquer forma, em Vasicek e em Bühlmann-Straub. Fora desse caso, que não é a maioria da amostra, usar o bruto abre mão de uma redução de erro de dois dígitos sem necessidade.
Entre os três regularizados, porém, a vantagem de Bühlmann-Straub é pequena. Bühlmann-Straub vence Blume com folga e vence Vasicek por margem estreita, nos cortes de ações líquidas da B3 analisados aqui. Esse resultado não se generaliza automaticamente para outros mercados. Um estudo recente com dez ações do índice alemão DAX encontrou um padrão diferente, com o ajuste simples de Blume à frente de Vasicek (MEYER-BULLERDIEK, 2024). O que a credibilidade de Bühlmann-Straub entrega não é só a vitória entre os três, é a explicação de por que todos batem o bruto, e de onde vem a vantagem pequena sobre Vasicek. Os dois chegam à mesma forma funcional, Zᵢ = τ̂²/(τ̂²+ŝeᵢ²), mas discordam em como τ̂² é estimado. Vasicek usa a variância amostral bruta dos β̂ᵢ, que mistura heterogeneidade real entre ações com o ruído médio de estimação. Bühlmann-Straub usa o estimador de momentos não paramétrico, que desconta esse ruído antes de atribuir o resto à heterogeneidade real, o que ajuda quando o ruído médio de estimação é grande relativo à dispersão real dos betas.
O ganho do shrinkage, em qualquer uma das três versões testadas, está concentrado onde a teoria prevê que deveria estar: ações pouco líquidas, cujo beta bruto é menos preciso. Para uma ação líquida, com beta já preciso, as três correções convergem para números parecidos, e esses números já estão próximos do beta bruto. A credibilidade não substitui precisão, organiza a falta dela.
Limitações
Três limitações merecem destaque para quem for usar esses números fora deste exercício. Um prior setorial genuíno não foi testado, porque a B3 não publica um arquivo de classificação setorial em lote, e o substituto usado na frente de sensibilidade, tercil de liquidez, é um proxy fraco de setor econômico de fato. Qualquer carteira de mercado construída a partir do COTAHIST herda a concentração setorial da própria B3, pesada em commodities (petróleo, mineração) e bancos, de modo que o beta medido aqui descreve a relação com essa composição específica, diferente de uma carteira diversificada por setor ou geografia. E o alvo contra o qual os quatro estimadores são julgados é, como a seção sobre o piso de ruído mostrou, ele mesmo ruidoso, o que limita o quanto qualquer comparação de RMSE nesta amostra consegue separar precisão real de ruído de medição. Toda comparação numérica deste artigo vale para a amostra, o período e o método usados aqui: ações ON/PN de lote padrão da B3, COTAHIST 2005 a 2025, retornos semanais, janela de treino de três anos. Nenhum desses números é propriedade geral de qualquer um dos quatro estimadores fora desse escopo.
Referências
AGÊNCIA NACIONAL DE ENERGIA ELÉTRICA (ANEEL). Nota Técnica nº 37/2019-SRM/ANEEL. Processo 48500.001761/2018-10. Brasília, 11 mar. 2019.
BLUME, M. E. On the assessment of risk. The Journal of Finance, v. 26, n. 1, p. 1-10, 1971.
BÜHLMANN, H. Experience rating and credibility. ASTIN Bulletin, v. 4, n. 3, p. 199-207, 1967.
BÜHLMANN, H.; GISLER, A. A Course in Credibility Theory and its Applications. Berlin: Springer, 2005.
BÜHLMANN, H.; STRAUB, E. Glaubwürdigkeit für Schadensätze. Bulletin of the Swiss Association of Actuaries, v. 70, p. 111-133, 1970.
DAMODARAN, A. Estimating Risk Parameters. Working Paper S-CDM-99-02. Nova York: Stern School of Business, New York University, 1999.
KAAS, R.; GOOVAERTS, M.; DHAENE, J.; DENUIT, M. Modern Actuarial Risk Theory: Using R. 2. ed. Berlin: Springer, 2008.
LALLY, M. An examination of Blume and Vasicek betas. The Financial Review, v. 33, n. 3, p. 183-198, 1998.
MEYER-BULLERDIEK, F. The quality of Blume and Vasicek betas for forecasting systematic risk: evidence from a German stock portfolio. Journal of Applied Finance & Banking, v. 14, n. 6, p. 1-15, 2024.
OLIVEIRA, F. N.; CUNHA, F. C. S. Estimando betas de mercado com quebras estruturais. Revista Brasileira de Finanças, v. 15, n. 2, p. 251-286, 2017.
PINTO, R. C. Uma análise da utilização do coeficiente beta no setor elétrico brasileiro. 2008. Dissertação (Mestrado em Energia), Programa Interunidades de Pós-Graduação em Energia, Universidade de São Paulo, São Paulo, 2008.
VASICEK, O. A. A note on using cross-sectional information in Bayesian estimation of security betas. The Journal of Finance, v. 28, n. 5, p. 1233-1239, 1973.