

Uma mesa de crédito que precisa do percentil 99,9% da perda agregada de uma carteira, para alocar capital ou dimensionar uma provisão, enfrenta uma distribuição composta: um número aleatório de defaults, cada um com uma perda de tamanho aleatório. A atuária resolveu esse problema décadas atrás, e a indústria de crédito já embutiu essa solução no CreditRisk+, um modelo de mercado para portfólio de crédito (CREDIT SUISSE FINANCIAL PRODUCTS, 1997). O Banco Central já aplicou esse modelo a uma carteira hipotética com dado da Central de Risco de Crédito (SCHECHTMAN, 2002), e a combinação entre CreditRisk+ e a recursão de Panjer já foi estudada na literatura acadêmica brasileira (MARANHÃO, 2010).
A parte 1 desta série mostrou que a credibilidade de Bühlmann-Straub bate os atalhos de mercado para o shrinkage do beta de uma ação. Este artigo muda de problema, para outro capítulo da mesma teoria do risco coletivo (KAAS et al., 2008): como somar, com exatidão até o limite da própria discretização, a distribuição de uma soma aleatória de parcelas aleatórias, sem simulação. A recursão de Panjer (PANJER, 1981) e a transformada rápida de Fourier (FFT, do inglês Fast Fourier Transform) fazem isso para a classe (a,b,0). Essa classe reúne as distribuições do número de eventos N em que a probabilidade de k eventos, pₖ, vem da probabilidade de k−1 eventos multiplicada por (a + b/k), com a e b constantes próprias de cada distribuição. O “0” indica que essa regra vale desde k=1, a partir de p₀=P(N=0). Dela fazem parte a Poisson, a binomial e a binomial negativa, as frequências mais usadas em crédito e em seguros. O que segue explica os dois métodos, testa os dois numa carteira calibrada em dado público brasileiro e lista as condições que decidem se o resultado sai certo.
A carteira usada no teste é hipotética, construída a partir de parâmetros calibrados em dado público. Cada evento é um default numa operação de empréstimo a uma pessoa jurídica, num período de um ano. A frequência N conta quantos defaults acontecem no período, com E[N] variando de 1, carteira pequena, a 1.000, carteira grande, nos quatro níveis testados adiante. A severidade X é a perda de cada default, em unidades da perda média, lognormal, com dispersão ancorada na perda dado o default (LGD, do inglês loss given default) do Working Paper 193 do Banco Central. A carteira tem um único fator de risco, sem a correlação entre setores que o CreditRisk+ completo modela com um fator Gama por setor. O valor em risco (VaR, do inglês Value at Risk) a 99,9% é a perda agregada tal que, em 999 de cada 1.000 períodos anuais como esse, a carteira perderia menos do que isso.
O problema de somar perdas sem simular
Uma carteira de crédito sofre, num período, um número aleatório de eventos de default N, cada um causando uma perda aleatória X. A perda agregada da carteira é a soma
uma distribuição composta, porque mistura a incerteza sobre quantos eventos ocorrem (a frequência) com a incerteza sobre o tamanho de cada um (a severidade). O capital de crédito sob a abordagem de classificações internas (IRB, do inglês Internal Ratings-Based) de Basileia II é dimensionado no percentil 99,9% dessa distribuição: a essa confiança, espera-se que uma instituição sofra perdas acima do capital de nível 1 e 2 em média uma vez a cada mil anos (BASEL COMMITTEE ON BANKING SUPERVISION, 2005). O VaR a 99,9% é o quantil da perda agregada nesse nível, e a perda esperada condicional (Expected Shortfall, ES) é a média das perdas que excedem esse quantil, mais sensível ao formato da cauda do que o quantil isolado:
Simular S é conceitualmente simples. Sortear N, sortear N valores de X, somar, repetir milhares ou milhões de vezes, e ler o percentil 99,9% da amostra. O problema está na própria definição do percentil. A uma confiança de 99,9%, apenas uma em mil simulações cai na região que define o quantil, de modo que o erro de amostragem do estimador de VaR e ES não cai à mesma taxa que o erro de uma média simples, mais lento e mais ruidoso quanto mais extremo o percentil.
A recursão de Panjer e a transformada de Fourier
A alternativa que a atuária desenvolveu evita simular ao explorar essa propriedade recursiva da frequência. Em termos formais, a razão entre probabilidades consecutivas de N é afim em 1/k, para (a,b) fixos por distribuição:
A classe (a,b,1) desloca o início da recursão para k=2, com p₀ e p₁ livres, fora do escopo aqui. Sundt e Jewell (1981) provaram que, entre as distribuições não degeneradas, só a Poisson, a binomial negativa e a binomial satisfazem essa recursão. A tabela abaixo traz a, b e p₀ de cada uma. O sinal de a já indica a dispersão da frequência, com a<0 na binomial correspondendo a subdispersão, a=0 na Poisson a equidispersão e a>0 na binomial negativa a superdispersão, o mesmo a>0 que, calibrado no SCR.data, a base de dados abertos do Sistema de Informações de Crédito do Banco Central, explode o domínio mais adiante.
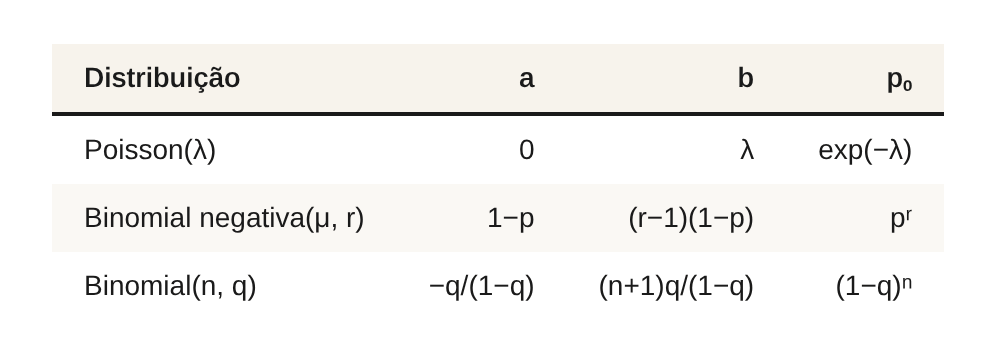
Panjer mostrou que essa relação se propaga para a distribuição agregada S, após discretizar a severidade num grid de largura h (PANJER, 1981). Discretizando X em múltiplos inteiros de h pelo método do arredondamento, a massa de cada intervalo [(k−½)h, (k+½)h) é atribuída ao ponto kh,
a recursão de Panjer entrega a distribuição agregada inteira, ponto a ponto, num único laço:
onde P é a função geradora de probabilidade (PGF, do inglês probability generating function) da frequência, P(z)=E[zᴺ]. O detalhe que costuma passar batido é a condição inicial, g₀=P(f₀), a PGF avaliada na massa que a própria discretização colocou no ponto zero (KLUGMAN; PANJER; WILLMOT, 2019). Ela coincide com P(N=0) só quando f₀=0, caso comum em exemplos de livro-texto, e a igualdade deixa de valer quando o arredondamento empurra massa real para o ponto zero, o que acontece quando h não é pequeno o bastante perto da escala da severidade, o assunto central deste artigo.
Quando λ é grande, exp(−λ) sofre underflow de representação em ponto flutuante, um problema conhecido da recursão de Panjer com frequência grande (GERHOLD; SCHMOCK; WARNUNG, 2010). A mitigação usada aqui reescala a recursão para começar de g₀=1, reescalonando de novo sempre que o valor foge de uma faixa segura em ponto flutuante, e revertendo a escala só ao final por normalização direta da soma, sem mudar a forma relativa da distribuição.
A FFT resolve o mesmo problema convertendo a convolução em produto no domínio da frequência. A função característica da severidade discretizada é calculada nos n pontos da grade de uma só vez, a PGF de N é aplicada ponto a ponto a esse vetor, e a transformada inversa devolve a distribuição agregada, em O(n log n) em vez do O(n²) da recursão direta:
A FFT trata a grade como circular, de modo que a massa que deveria cair acima do limite superior do domínio reaparece perto de zero, o fenômeno de aliasing (EMBRECHTS; FREI, 2009). A mitigação padrão estende o domínio com zeros antes da transformada (zero-padding), empurrando essa massa residual para fora do resultado final. Uma segunda mitigação, o exponential tilting, pondera a severidade por exp(θkh) antes da transformada, deslocando a massa de interesse para uma região menos sujeita ao enrolamento circular.
Os detalhes de implementação, incluindo os dois mecanismos de reescala contra underflow e a aplicação do tilting, estão no módulo AggregateLoss.jl do repositório público, em Julia.
Frequência calibrada no SCR.data, severidade ancorada no Working Paper 193
Testar os dois algoritmos exige escolher uma frequência e uma severidade. A escolha aqui evita o parâmetro arbitrário de um exemplo de livro-texto e ancora os dois nos dados públicos brasileiros disponíveis, declarando onde a cobertura desses dados termina e onde a calibração vira aproximação.
A frequência vem do SCR.data, publicado mensalmente desde julho de 2012, com a carteira ativa e a inadimplência acima de 90 dias por célula de unidade da federação (UF), modalidade, porte, pessoa física ou jurídica e setor da Classificação Nacional de Atividades Econômicas (CNAE). O recorte usado aqui soma, por setor CNAE, pessoa jurídica, modalidade Empréstimos, todo o Brasil, nos quatro trimestres completos de 2025, excluindo células com até 15 operações, suprimidas por sigilo bancário. Como o SCR.data não registra uma contagem direta de eventos de default, o número de operações inadimplentes por setor é aproximado por número de operações × (carteira vencida acima de 90 dias ÷ carteira ativa), assumindo que elas têm, em média, o tamanho médio das operações do setor.
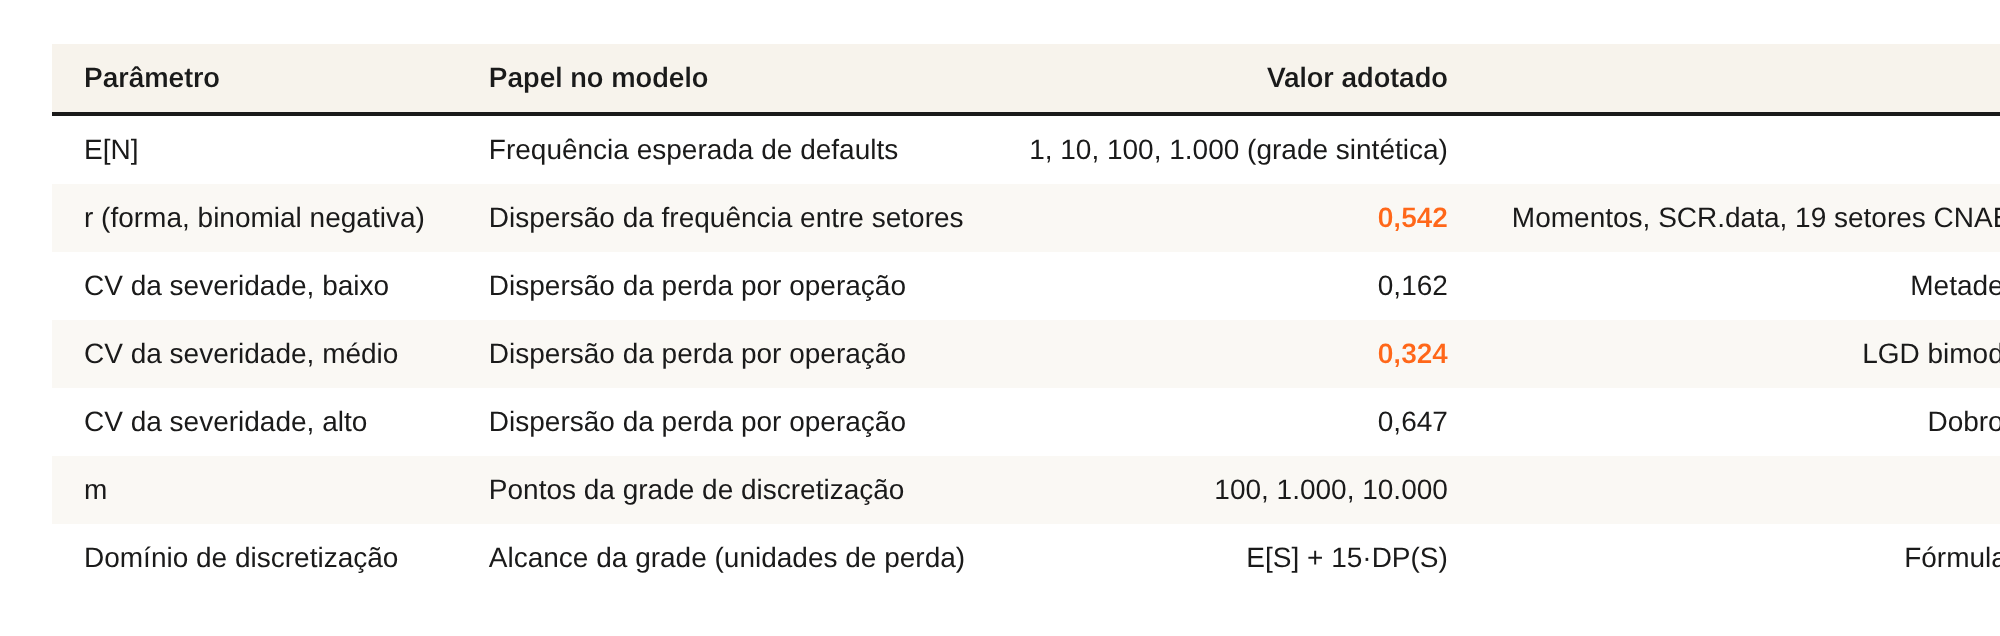
A dispersão entre os setores CNAE é bem maior do que uma Poisson permitiria. No corte transversal de 2025, a razão entre variância e média da frequência implícita de default ficou entre 11.659 e 17.362 nos quatro trimestres, coerente com a estrutura do CreditRisk+, em que a taxa de default de cada setor carrega um fator sistemático Gama-distribuído, que torna a mistura Poisson-Gama equivalente a uma binomial negativa (CREDIT SUISSE FINANCIAL PRODUCTS, 1997). Ajustando essa binomial negativa pelo método dos momentos (variância μ+μ²/r) em cada ano completo do SCR.data, de 2012 a 2025, a mediana do parâmetro de forma entre os 14 anos disponíveis é r≈0,542, adotado na grade de teste principal. Os dois extremos, r≈0,413 em 2021 e r≈0,720 em 2025, são examinados numa seção de robustez mais adiante. O r mediano entra em todos os cenários sintéticos da grade, de E[N]=1 a E[N]=1.000, uma extrapolação explícita da escala de milhares de operações para cenários muito menores.
A severidade não tem o mesmo tipo de dado público, já que nenhuma fonte aberta brasileira registra a perda por operação em nível individual, por sigilo bancário. A referência mais próxima é o Working Paper 193 do Banco Central, que estima a LGD em 9.557 operações prefixadas não-varejo do Sistema de Informações de Crédito (SCR) entre 2003 e 2007, encontrando uma distribuição bimodal, com média entre 47% e 92% a depender da metodologia (SILVA; MARINS; NEVES, 2009). Tratando os dois números como os modos de uma mistura de dois pontos com peso igual, o coeficiente de variação (CV) implícito é 0,324, adotado como CV “médio”, com os níveis “baixo” e “alto” em metade e o dobro desse valor. A severidade é lognormal, com média normalizada em 1 unidade de perda, já que o teste compara métodos numéricos entre si, não a escala monetária absoluta.
A grade fatorial e a referência de Monte Carlo
O teste cruza quatro níveis de frequência esperada, E[N] igual a 1, 10, 100 ou 1.000, com Poisson e binomial negativa de mesma média, três CVs de severidade e três tamanhos de grade, m igual a 100, 1.000 ou 10.000, totalizando 72 células. Em cada célula, Panjer, FFT sem e com tilting, e Monte Carlo rápido de 10⁴ e 10⁵ simulações são comparados contra uma referência de Monte Carlo de 10⁷ simulações, cinco sementes de 2×10⁶ cada, nas métricas de erro relativo do VaR e do ES a 99,9%, e distância de Kolmogorov-Smirnov na cauda acima do percentil 99. O domínio é dimensionado pelas fórmulas de momento do composto, E[S] mais 15 desvios-padrão de S, antes de escolher h=domínio/m.
A própria referência de Monte Carlo carrega ruído de amostragem, medido entre as cinco sementes. Para a Poisson, o desvio-padrão entre sementes do VaR 99,9% fica entre 0,02% e 0,20% da média, em cenários de E[N]=1 a E[N]=1.000. Para a binomial negativa do SCR.data, mais dispersa, o ruído é maior, de 0,30% a 0,66%, relevante o bastante para que diferenças de erro abaixo de meio ponto percentual nesses cenários não sejam lidas como sinal forte sobre o método.
Precisão de Panjer e FFT numa grade bem ajustada
Restrito aos cenários em que a largura de discretização h fica abaixo de 0,3 vez o desvio-padrão da severidade, a condição que a seção seguinte mostra ser a que de fato importa, são 16 dos 24 cenários da grade de 10.000 pontos. Panjer e FFT acertam o VaR 99,9% com folga nesses 16, medido contra a referência de Monte Carlo de 10⁷ simulações.
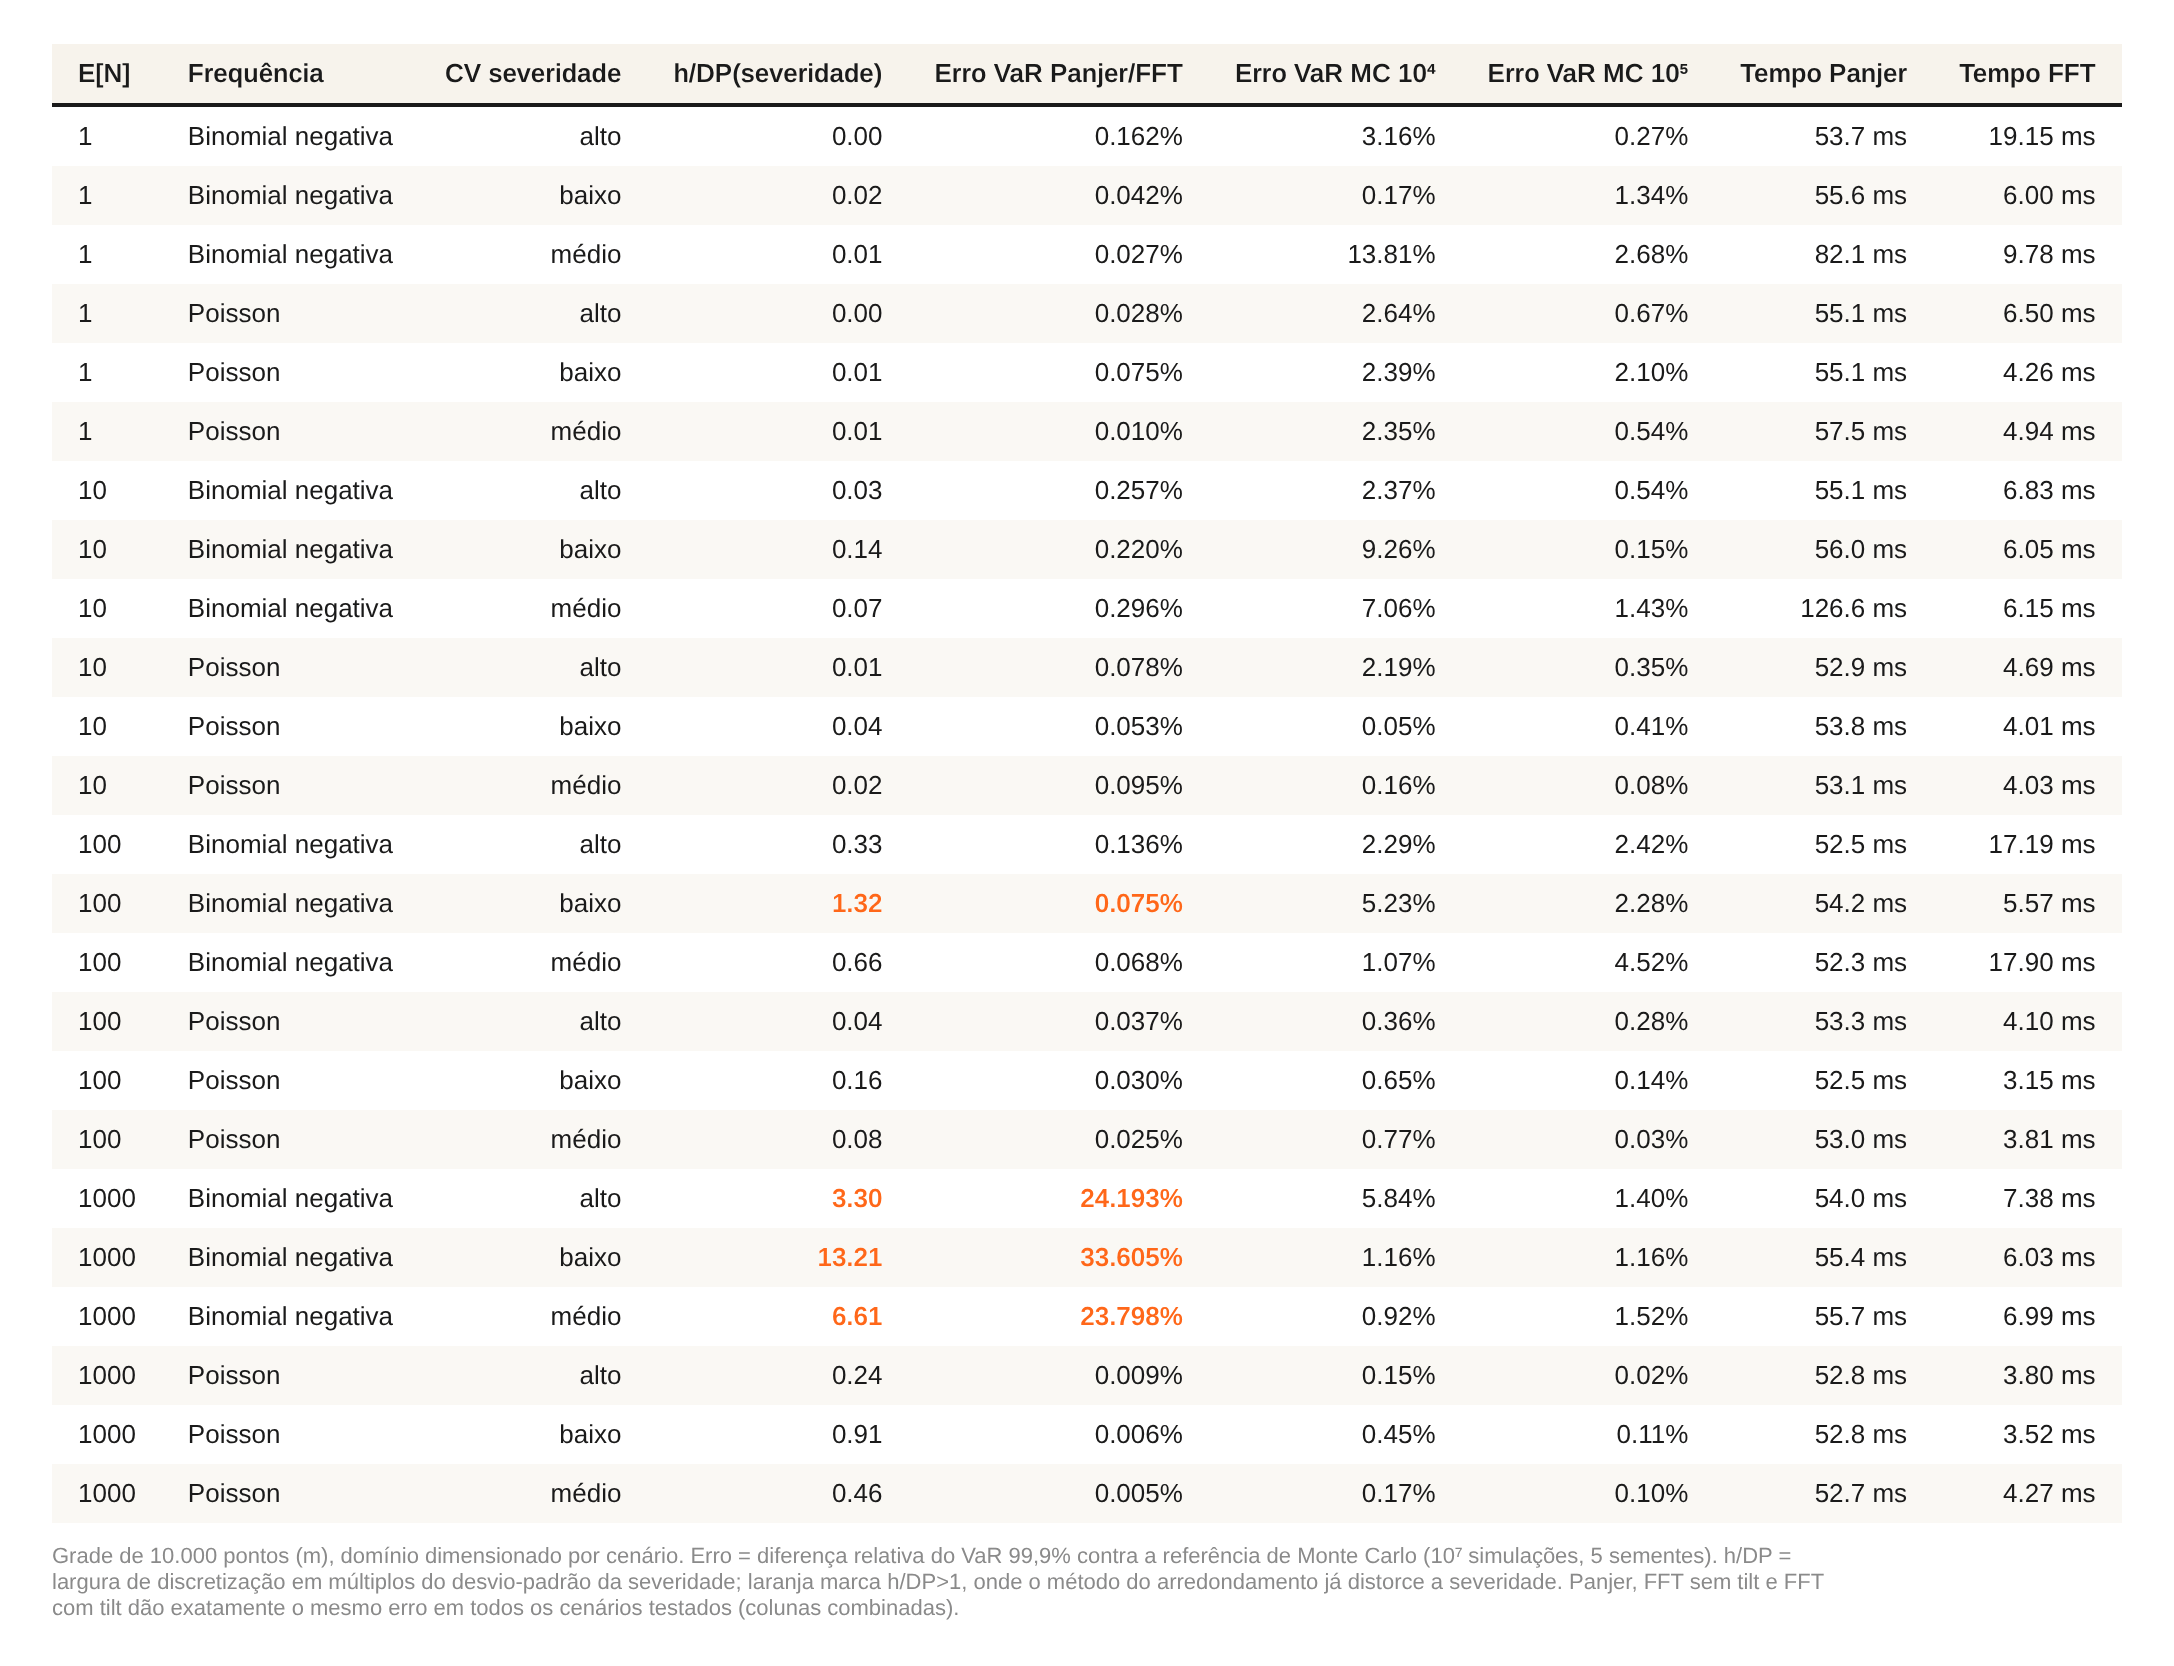
O erro absoluto médio do VaR 99,9% nesses 16 cenários já é pequeno, perto de 0,1% tanto para Panjer quanto para a FFT, mas essa referência de Monte Carlo carrega ruído de amostragem da mesma ordem de grandeza. Contra uma referência determinística, a FFT em m=1.000.000 no mesmo domínio, o erro real de Panjer e da FFT em m=10.000 cai para entre 0,0004% e 0,0098% nesses 16 cenários, mediana de 0,0056%, abaixo de 0,01% em todos eles. Essa referência de alta resolução se sustenta na convergência entre algoritmos e resoluções diferentes: Panjer em m=10.000 já bate com a FFT em m=1.000.000 dentro de 0,01%, e o Monte Carlo de 10⁷ confirma essa referência dentro do próprio ruído, com diferença entre 0,004% e 0,30%.
Pela raiz do erro quadrático médio (RMSE) entre sementes independentes, o erro esperado do Monte Carlo a 10 milhões de simulações só fica abaixo do erro de Panjer em m=10.000 em 1 dos 16 cenários. Nos outros 15, a distribuição calculada por Panjer ou pela FFT já é mais precisa do que o Monte Carlo alcança mesmo na maior amostra testada aqui.
O padrão de Expected Shortfall acompanha de perto o de VaR em toda a grade, sem nenhum cenário com os dois se descolando, e a distância de Kolmogorov-Smirnov na cauda segue a mesma lógica, perto de zero nos cenários bem discretizados e saltando para perto do máximo exatamente nos cenários em que a largura de discretização falha, o assunto da próxima seção.
A largura da grade decide o resultado
A largura h certa depende do desvio-padrão da própria severidade, não de uma unidade absoluta de perda. O erro absoluto do VaR 99,9% de Panjer e FFT cresce de forma abrupta, não gradual, em torno de h entre 0,3 e 1 desvio-padrão da severidade.
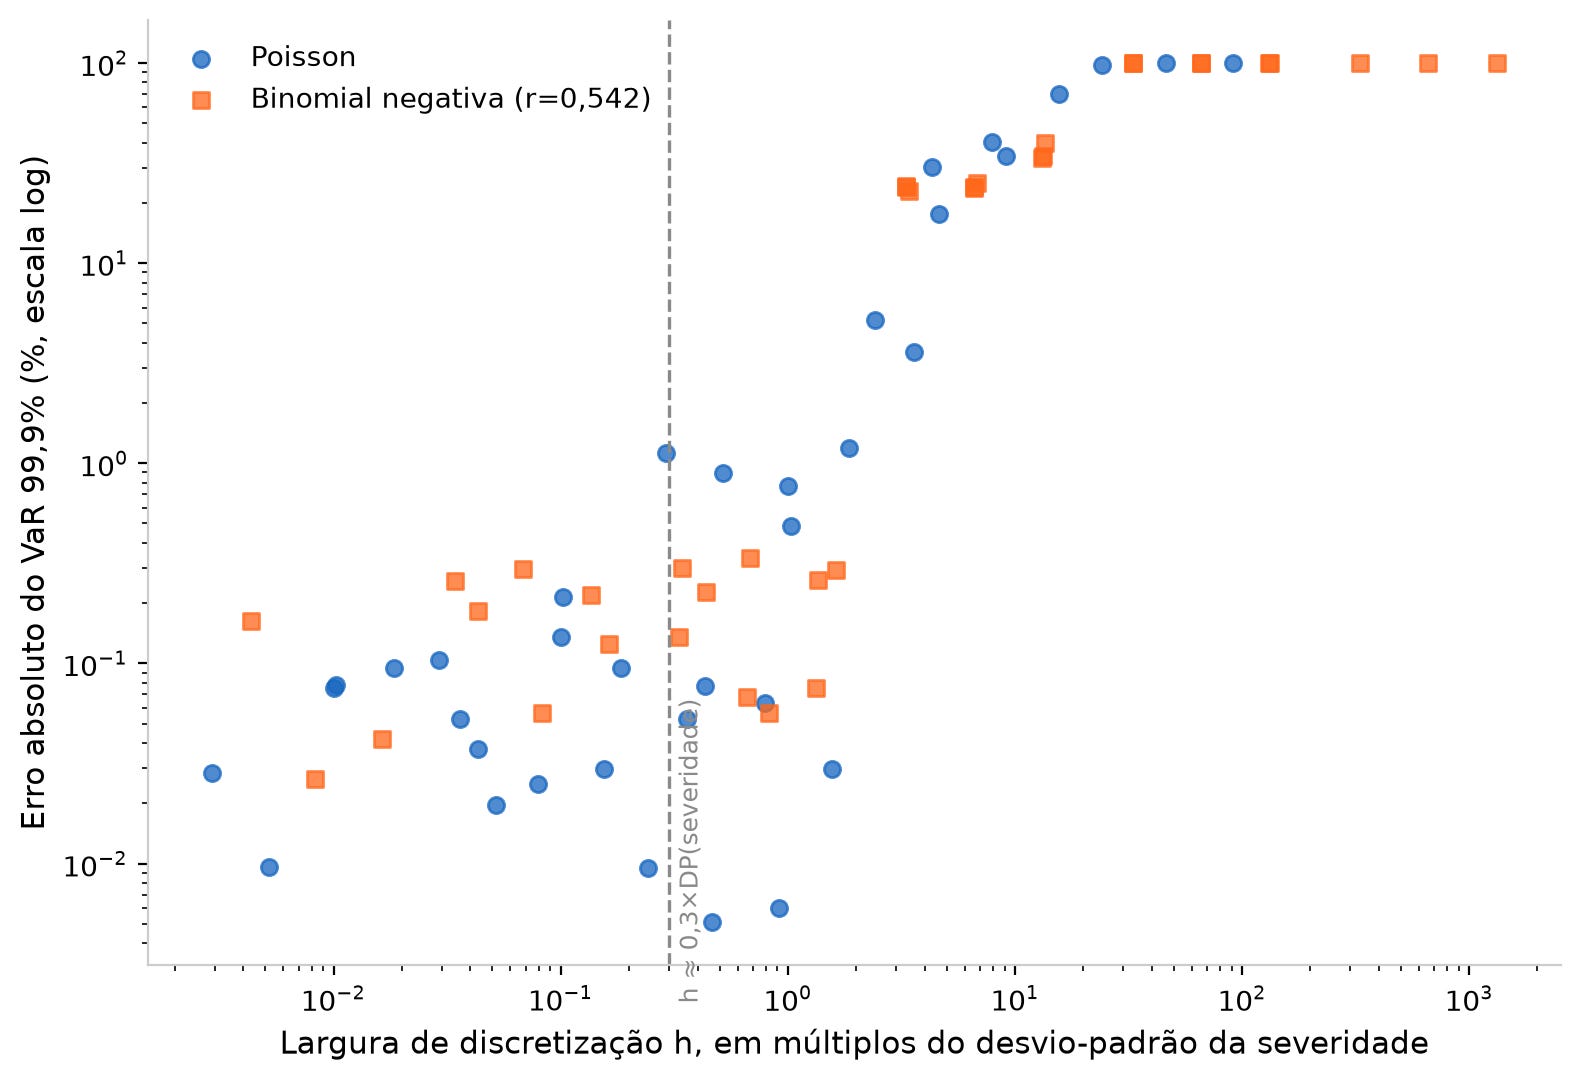
Abaixo de h=0,1 desvio-padrão, o erro absoluto médio é 0,09%, e sobe a 0,24% entre 0,1 e 0,3, ainda dentro do ruído da referência. Entre 1 e 3 desvios-padrão, a média salta para 1,0%, mediana de 0,4%, com casos isolados chegando a 5,2%. Entre 3 e 10, o erro médio é 24,6%, entre 10 e 30 é 54,9%, e acima de 30 o resultado colapsa por completo, erro próximo de 100%, em todos os cenários testados nessa faixa.
O mecanismo por trás desse colapso aparece nos próprios números calculados. Quando h é grande em relação ao desvio-padrão da severidade, o método do arredondamento concentra quase toda a massa de probabilidade em um ou dois pontos da grade, deslocando a média efetiva da severidade para longe da verdadeira. Severidade com desvio-padrão 0,16 (CV baixo), discretizada com h=1,48 num cenário de E[N]=1.000 com Poisson, teve sua média efetiva deslocada em 43%, distorção que se propaga para toda a distribuição composta. Panjer e FFT calculam o resultado exato para a severidade discretizada que receberam, mas essa severidade já não era a certa, antes mesmo de a recursão ou a transformada entrarem em ação.
A dispersão real do crédito setorial explode o domínio
A binomial negativa calibrada na dispersão setorial do SCR.data torna esse problema de largura bem mais severo do que a Poisson de mesma média, porque sua variância é dominada pelo termo μ²/r. No cenário de E[N]=1.000, o domínio necessário salta de cerca de 1.480 unidades de perda na Poisson para cerca de 21.380 na binomial negativa, confirmado por simulação direta, refletindo dispersão real da frequência, não um artefato da fórmula usada para dimensioná-lo.
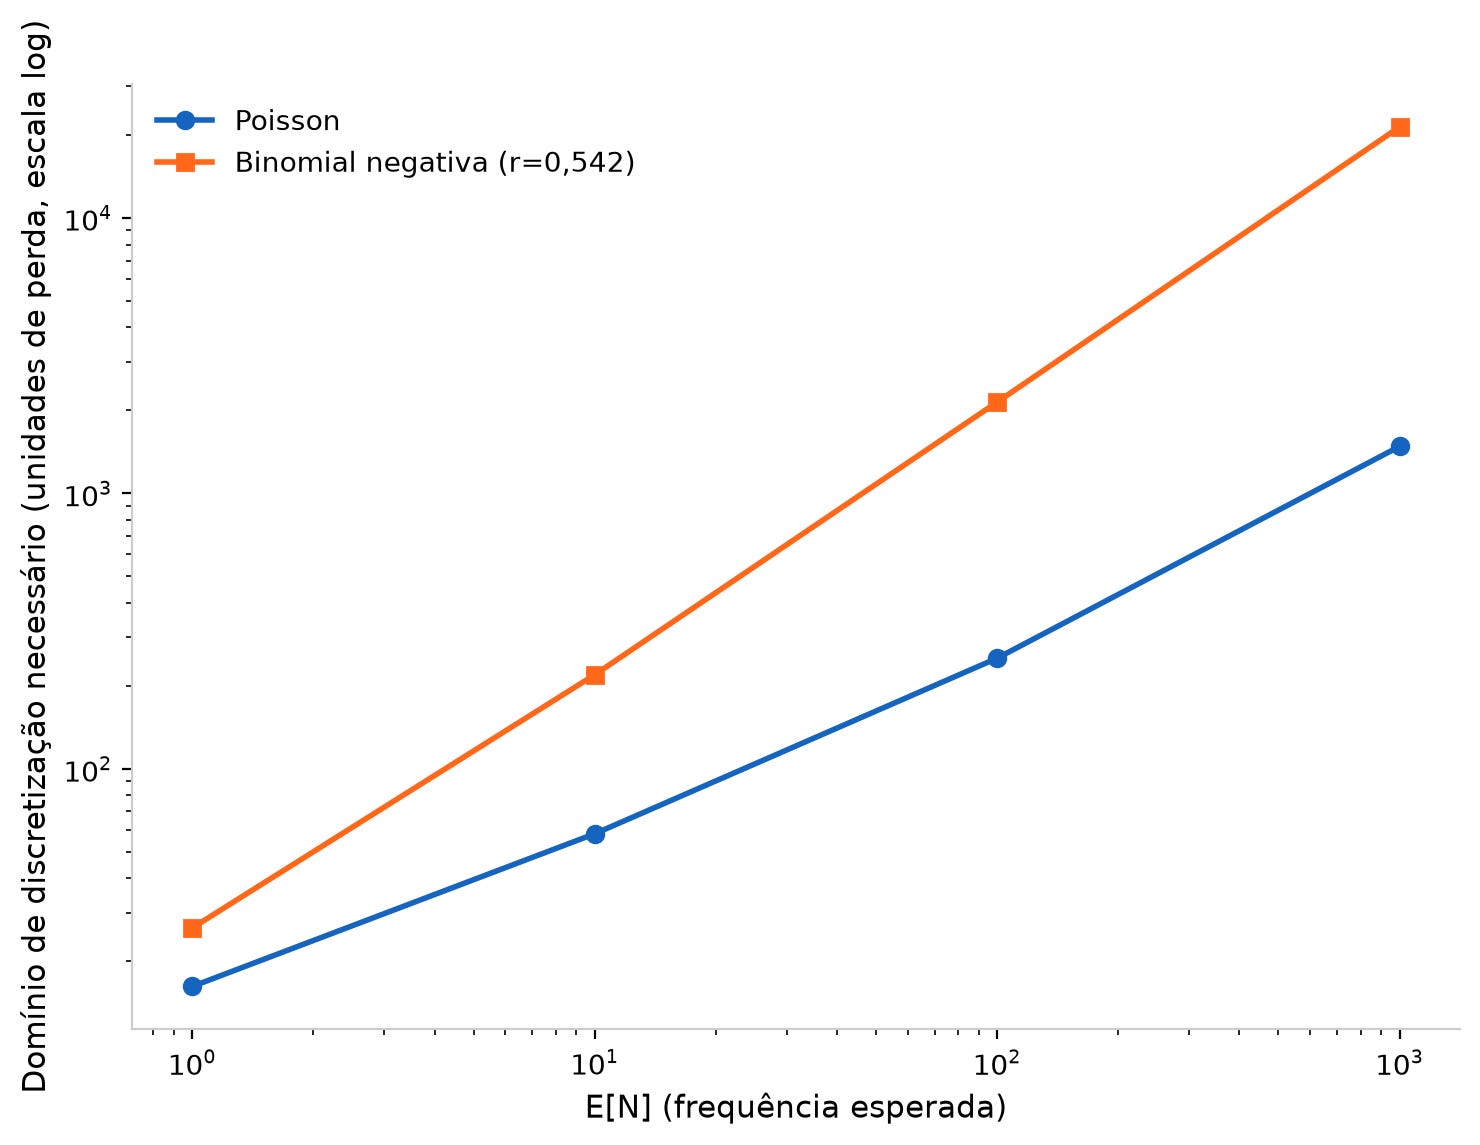
Combinado com a exigência de largura pequena perto do desvio-padrão da severidade, esse domínio maior deixa a grade de 10.000 pontos, a maior testada aqui, sem resolução suficiente nos cenários de binomial negativa com E[N]=1.000. O erro do VaR 99,9% nessa grade variou de 23,8% a 33,6%, contra erro abaixo de 0,01% no cenário de Poisson equivalente. É justamente aqui que a vantagem de Panjer e da FFT se inverte, com o Monte Carlo errando menos, de 0,92% a 5,84%, mesmo com apenas 10⁴ simulações. Alcançar h abaixo de 0,3 vez o desvio-padrão nesse cenário exigiria uma grade de 110.000 a mais de 440.000 pontos, uma a quase duas ordens de grandeza acima do maior grid testado aqui.
O regime medido aqui é a dispersão de frequência observada nos próprios dados públicos do SCR.data, não um cenário hipotético escolhido para forçar uma falha. Um analista que aplicasse Panjer ou FFT com uma grade redonda, 10.000 pontos por exemplo, sem checar h contra o desvio-padrão da severidade, correria o risco real de um VaR errado em dezenas de pontos percentuais, até cerca de 77% no extremo mais disperso observado, sem nenhum aviso do algoritmo.
Testando os dois extremos da série, não só a mediana
O r≈0,542 usado na grade principal é a mediana entre 14 anos de dispersão setorial medida no SCR.data, mas o r de um ano específico pode ficar bem longe dessa mediana. Repetindo a mesma estimativa, ano a ano, desde 2012, o r anual varia de 0,413 em 2021, o ano de maior dispersão setorial observada, a 0,720 em 2025, o ano de menor dispersão.
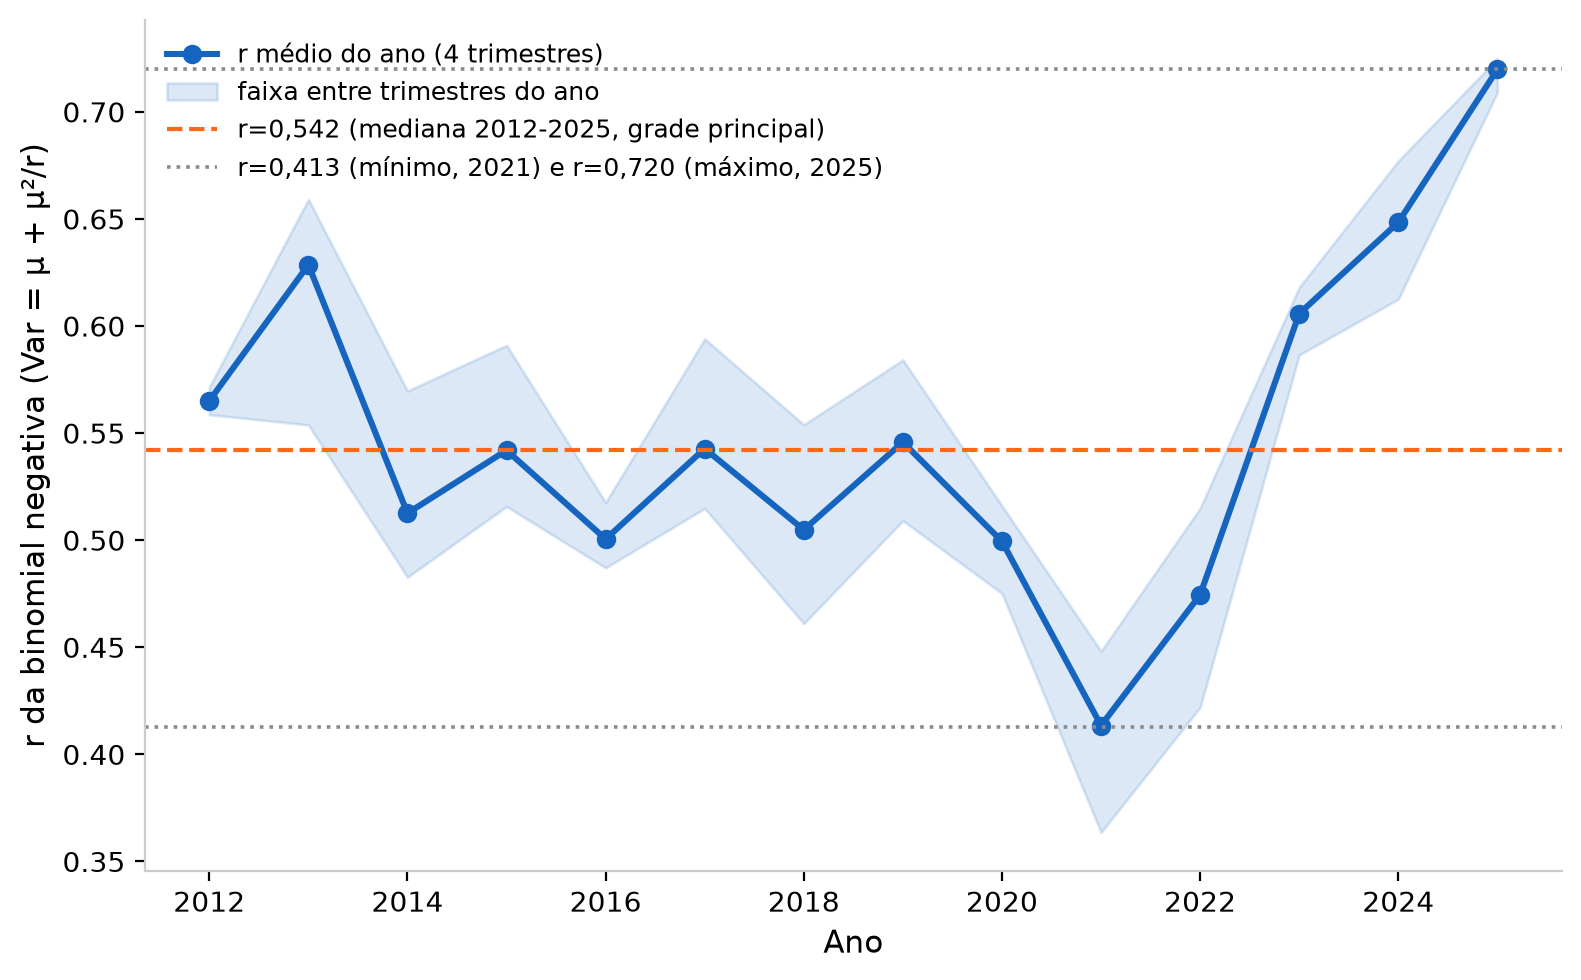
Rodando a mesma grade de binomial negativa (E[N]=100 e E[N]=1.000, três CVs, grade de 10.000 pontos) nos dois extremos, o padrão medido com a mediana se confirma nas duas pontas. Em E[N]=100, o erro de Panjer e da FFT fica pequeno nos três valores de r: 0,07% a 0,25%. Em E[N]=1.000, o erro cresce de forma acentuada à medida que r cai, de 2,3%-18,4% no extremo menos disperso até 33,7%-76,5% no mais disperso, porque o domínio necessário cresce junto. O Monte Carlo passa a errar menos que Panjer e a FFT na mediana e no extremo mais disperso, nos três CVs, e em dois dos três no extremo menos disperso.
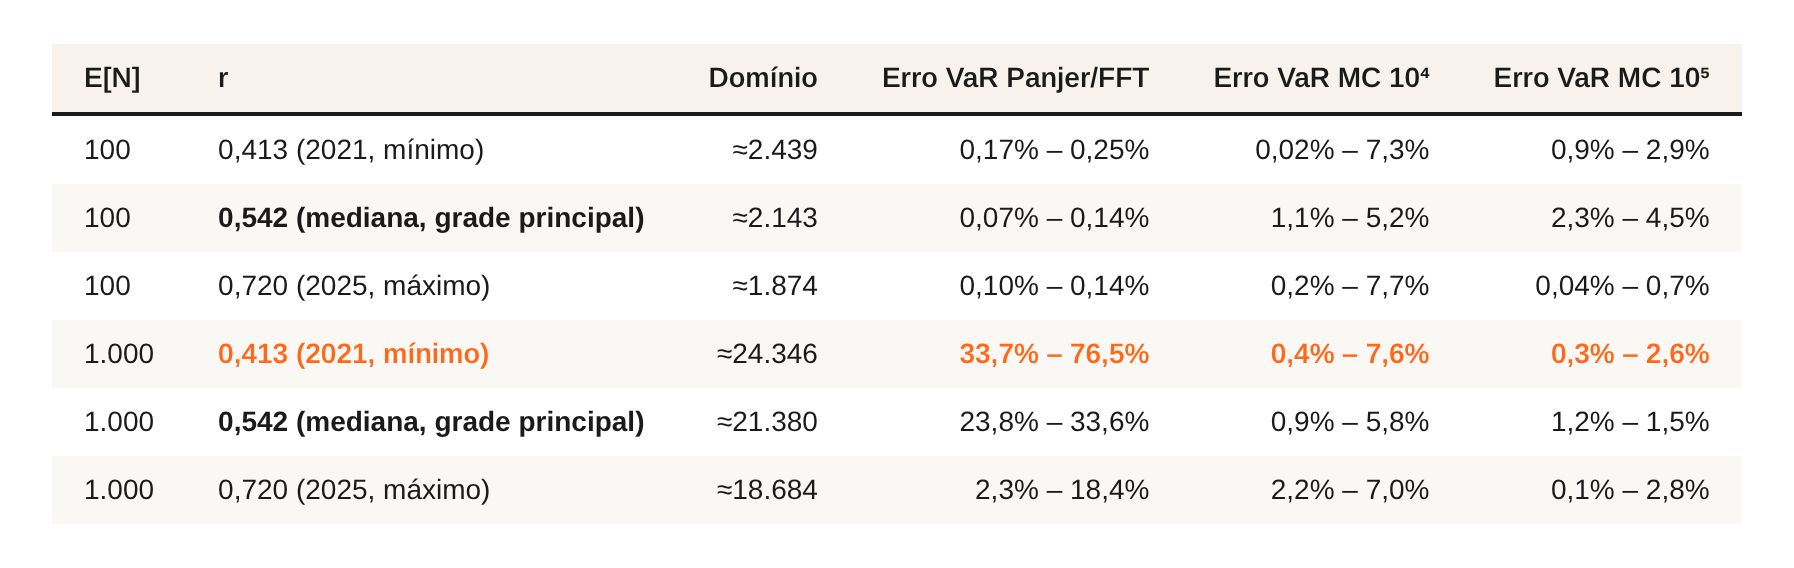
Nesta amostra, a vantagem de Panjer e da FFT quando a grade é bem ajustada à severidade, e a perda dessa vantagem quando a frequência é muito dispersa, se mantêm nos dois extremos da série, não só na mediana da grade principal, condicionado a este período e a este método de estimação.
Underflow e aliasing, medidos
O underflow de exp(−λ) apareceu, nesta grade, apenas nos cenários de Poisson com E[N]=1.000, onde λ≈745 já ultrapassa o limite de representação em ponto flutuante duplo, resolvido pela reescala descrita acima. Em nenhum cenário de binomial negativa o underflow de P(N=0) ocorreu, porque essa probabilidade, perto de 0,017 para r=0,542 e média 1.000, decai bem mais devagar com a média do que o exp(−λ) de uma Poisson. Com zero-padding de quatro vezes o tamanho da grade de interesse, nenhum cenário mostrou efeito de aliasing mensurável nos 72 cenários testados, e o exponential tilting não mudou nenhum resultado nesta grade específica.
Quanto custa chegar à mesma precisão
Panjer e a FFT entregam a distribuição inteira da perda agregada de uma vez, sem simular nenhum cenário, ao custo de resolver a recursão ou a transformada na grade escolhida. O Monte Carlo chega ao mesmo VaR por simulação direta, e o tempo que isso leva depende de quanta tolerância de erro é aceitável. Nos 16 cenários bem discretizados descritos acima, medindo o tempo até cada tolerância de erro do VaR 99,9% (remedido num único ambiente, com aquecimento da compilação e mediana de sete execuções, incluindo discretização e extração do quantil tanto para Panjer e a FFT quanto para o Monte Carlo):
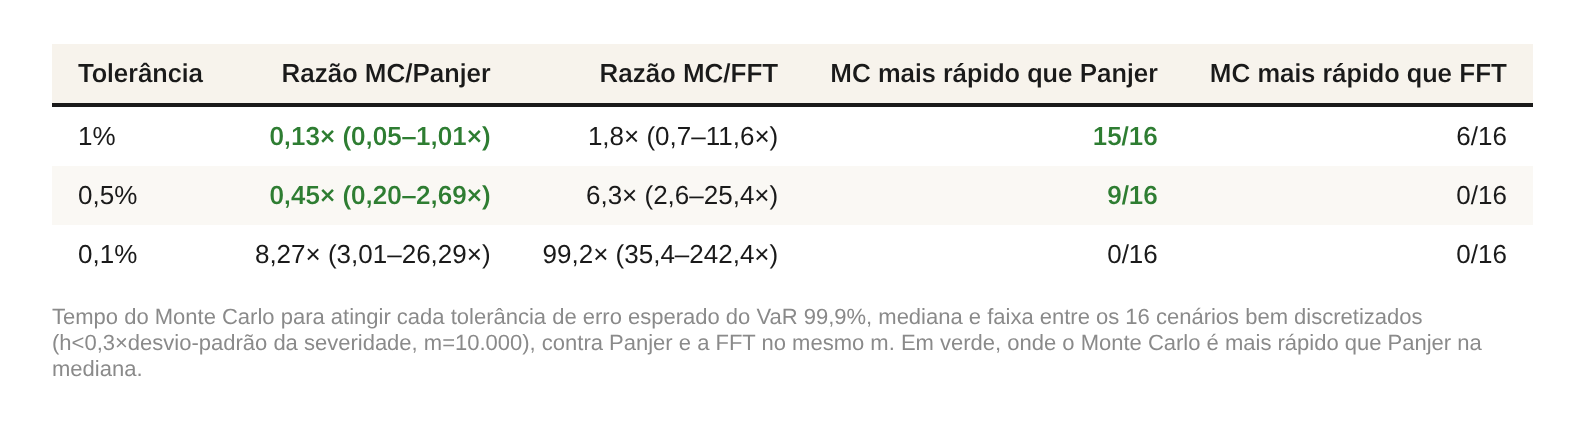
A 1% de tolerância, a FFT já é mais rápida que o Monte Carlo em 10 dos 16 cenários, 2,6 vezes na mediana desses 10 (1,8 vez na mediana dos 16, que inclui os cenários em que o Monte Carlo vence). O Monte Carlo ainda vence os outros 6, todos de Poisson com E[N]=1 ou E[N]=10, por margem pequena. A 0,5% de tolerância, a FFT vence nos 16 cenários, mediana de 6,3 vezes, e Panjer já compensa nos cenários de binomial negativa. Contra Panjer, porém, o Monte Carlo continua mais rápido em nove dos dez cenários de Poisson, com empate técnico em E[N]=1.000, travado no piso de 10 mil simulações testado aqui. A 0,1% de tolerância, Panjer e a FFT vencem nos 16 cenários, Panjer de 3 a 26 vezes mais rápido (mediana de 8,3) e a FFT de 35 a 242 vezes (mediana de 99). Em 8 desses 16 cenários, o Monte Carlo não chegou a 0,1% nem com 10⁷ simulações, e a razão é um limite inferior.
O Monte Carlo fica competitivo justamente onde a tolerância é frouxa e a frequência é baixa, Poisson com poucos eventos esperados, caso em que poucas simulações já bastam. Quando a tolerância aperta ou a frequência é fortemente dispersa, como a binomial negativa calibrada no SCR.data, a vantagem determinística de Panjer e da FFT cresce rápido, e o Monte Carlo precisaria de ordens de magnitude mais simulações para alcançar a mesma precisão.
O que checar antes de usar Panjer ou FFT
As seções anteriores medem cada um desses pontos em separado. Reunidos, formam uma lista curta de checagens a fazer antes de confiar num resultado de Panjer ou FFT, condicionada a esta amostra, a este desenho de teste e aos métodos implementados aqui.
A largura de discretização h importa em relação ao desvio-padrão da severidade, não em unidade absoluta de perda nem ao tamanho nominal da grade. Nesta amostra, o erro cresce de forma abrupta a partir de h entre 0,3 e 1 desvio-padrão da severidade. Abaixo de 0,3 desvio-padrão da severidade, o erro fica perto do próprio ruído de amostragem da referência.
Panjer e FFT não avisam quando erram. Com h grande demais, os dois devolvem um número plausível, mesmo com a severidade discretizada já distorcida. O Monte Carlo, nesse mesmo regime mal condicionado, degrada de outro jeito, ficando mais ruidoso com menos simulações, sem produzir esse tipo de erro sistemático silencioso.
Vale dimensionar o domínio de discretização e checar h contra o desvio-padrão da severidade antes de confiar no resultado, sobretudo quando a frequência é fortemente dispersa, como a binomial negativa do SCR.data. Foi nesse regime, E[N]=1.000 com binomial negativa, que o domínio necessário excedeu a grade de 10.000 pontos testada aqui, e o Monte Carlo passou a errar menos que Panjer e a FFT.
Em grades grandes, a FFT tende a ser a rota determinística mais barata, porque seu custo O(m log m) cresce bem mais devagar que o O(m²) da recursão direta de Panjer. Já em m=10.000, Panjer perdeu em tempo para o Monte Carlo na maior parte dos cenários de Poisson a 1% e a 0,5% de tolerância.
O underflow de exp(−λ) é um problema específico de Poisson com frequência grande. Nesta implementação, apareceu só a partir de λ≈745 e foi resolvido por reescala. P(N=0) da binomial negativa decai bem mais devagar com a média, e o underflow não ocorreu em nenhum cenário testado.
Com zero-padding de quatro vezes o tamanho da grade de interesse, o aliasing não apareceu em nenhum dos 72 cenários testados, e o exponential tilting não mudou nenhum resultado. Isso não torna o tilting inútil em geral, mas mostra que aqui quem de fato limitava a precisão era a largura de discretização, não o enrolamento circular da convolução.
Limitações
A grade testa um único fator de risco para a carteira inteira, mais próximo de dependência total entre setores do que de independência, sem a estrutura multissetorial do CreditRisk+, que usa um fator Gama por setor. O parâmetro r da binomial negativa carrega outra hipótese. Ele vem da heterogeneidade entre os 19 setores CNAE dentro de um mesmo trimestre, usada como proxy da variabilidade de um fator sistemático ao longo do tempo, não uma medição direta.
A soma composta também assume severidade independente da frequência, o que significa que a perda dado o default não piora quando o número de defaults sobe. A evidência em crédito aponta o contrário, com LGD maior em recessões, a razão de existir uma LGD de downturn no arcabouço de Basileia. Essas hipóteses afetam primeiro o nível da distribuição, e podem mudar a comparação de forma indireta, por exemplo se alterarem a dispersão o bastante para mudar o domínio de discretização necessário. O mecanismo central medido aqui, h pequeno perto do desvio-padrão da severidade, continua sendo o que decide a precisão de Panjer e da FFT, qualquer que seja o nível.
A severidade é paramétrica, ancorada no LGD agregado do Working Paper 193, sem validação contra perdas por operação, inexistentes em fonte pública. A frequência de default é aproximada a partir do número de operações e da taxa de inadimplência de cada setor, já que o SCR.data não registra uma contagem direta de eventos. O domínio é dimensionado por uma fórmula de momentos que funciona bem para Poisson, mas pode subestimar o necessário para frequências muito assimétricas, por isso checada aqui caso a caso. A grade testada vai até 10.000 pontos, e grades maiores poderiam mudar a leitura dos cenários de binomial negativa com E[N] grande. A referência de Monte Carlo usa 10⁷ simulações, no limite inferior recomendado na literatura, com o ruído remanescente medido e reportado.
Nesta amostra, neste desenho de teste e com os métodos implementados aqui, Panjer e a FFT calculam a distribuição inteira da perda agregada com precisão alta e custo previsível, desde que h fique pequeno perto do desvio-padrão da severidade. Quando essa condição não se verifica, nenhum aviso indica a falha, e a escolha depende de medir, não de assumir, se a combinação real de frequência e severidade permite uma grade viável.
Referências
BASEL COMMITTEE ON BANKING SUPERVISION. An Explanatory Note on the Basel II IRB Risk Weight Functions. Basileia: Bank for International Settlements, jul. 2005.
CREDIT SUISSE FINANCIAL PRODUCTS. CreditRisk+: A Credit Risk Management Framework. Technical Document. Londres, 1997.
EMBRECHTS, P.; FREI, M. Panjer recursion versus FFT for compound distributions. Mathematical Methods of Operations Research, v. 69, p. 497-508, 2009.
GERHOLD, S.; SCHMOCK, U.; WARNUNG, R. A generalization of Panjer’s recursion and numerically stable risk aggregation. Finance and Stochastics, v. 14, n. 1, p. 81-128, 2010.
KAAS, R.; GOOVAERTS, M.; DHAENE, J.; DENUIT, M. Modern Actuarial Risk Theory: Using R. 2. ed. Berlin: Springer, 2008.
KLUGMAN, S. A.; PANJER, H. H.; WILLMOT, G. E. Loss Models: From Data to Decisions. 5. ed. Hoboken: Wiley, 2019.
MARANHÃO, A. N. Distribuição de perda agregada no modelo CreditRisk+: análise comparativa do algoritmo recursivo de Panjer e o método de aproximações ponto de sela. 2010. Dissertação (Mestrado em Estatística), Programa de Pós-Graduação em Estatística, Universidade de Brasília, Brasília, 2010.
PANJER, H. H. Recursive evaluation of a family of compound distributions. ASTIN Bulletin, v. 12, n. 1, p. 22-26, 1981.
SCHECHTMAN, R. Descrição e uso de um modelo de risco de crédito ao nível de portfólio. In: BANCO CENTRAL DO BRASIL. Economia Bancária e Crédito: Avaliação de 3 Anos do Projeto Juros e Spread Bancário. Brasília: Banco Central do Brasil, 2002. cap. 8, p. 107-120.
SILVA, L.; MARINS, J.; NEVES, M. Loss Given Default: um estudo sobre perdas em operações prefixadas no mercado brasileiro. Working Paper 193. Brasília: Banco Central do Brasil, 2009.
SUNDT, B.; JEWELL, W. S. Further results on recursive evaluation of compound distributions. ASTIN Bulletin, v. 12, n. 1, p. 27-39, 1981.