

Lula terminou o 1º turno da eleição presidencial de 2026 com 2,2 milhões de votos a menos que Flávio Bolsonaro e venceu o 2º turno com 4,4 milhões de vantagem. A pergunta natural é de onde vieram os 6,6 milhões de votos de diferença, e ela não tem resposta direta, porque o voto é secreto e nenhum registro liga o eleitor que anulou no 1º turno ao voto que ele deu três semanas depois. O que o Tribunal Superior Eleitoral (TSE) publica são totais por seção eleitoral, cada uma com algumas centenas de eleitores, nos dois turnos. Reconstruir o comportamento individual a partir desses totais é o problema da inferência ecológica.
Em risco de crédito, quando uma carteira só informa quantos contratos estão em cada faixa de atraso em cada mês, e não a trajetória de cada contrato, a matriz de migração entre faixas precisa ser inferida das proporções agregadas, exatamente como a matriz de transição entre os turnos. A equivalência é formal (TEN CATE, 2018), e as técnicas usadas para o fluxo de votos, como mínimos quadrados com restrições, ajuste proporcional iterativo, bootstrap por agrupamento e calibração das faixas por simulação, reaparecem em matrizes de rating, na reconstrução de exposições interbancárias e na leitura de fluxos de fundos. O texto percorre o modelo aplicado às 500 mil seções de 2026, os resultados e as correspondências com finanças quantitativas.
O problema da inferência ecológica
Para cada seção a, com eleitorado Ea, conhecem-se as frações do eleitorado em cinco grupos no 1º turno (Lula, outros candidatos, Flávio, brancos e nulos, abstenção) e em quatro grupos no 2º turno (Lula, Flávio, brancos e nulos, abstenção). A incógnita é a matriz de transição B, de dimensão 5×4, cujo elemento βij é a probabilidade de um eleitor do grupo i no 1º turno estar no grupo j no 2º. Cada linha de B soma 1 e cada elemento fica entre 0 e 1.
A equação diz que a composição do 2º turno em cada seção é a mistura das linhas de B, ponderada pela composição do 1º turno. Se Flávio cresceu mais justamente nas seções onde os candidatos eliminados eram fortes, a regressão atribui aos eleitores desses candidatos uma taxa alta de migração para Flávio. É a variação entre centenas de milhares de seções que permite separar as linhas da matriz, e essa é a ideia da regressão ecológica (GOODMAN, 1953), que supõe B igual em todas as unidades.
A suposição é forte, porque os dados agregados não distinguem o comportamento individual de um efeito do lugar. Se, nas seções com mais brancos e nulos no 1º turno, o bairro inteiro foi mais para Lula no 2º, a regressão atribui esse movimento aos próprios eleitores de branco e nulo, quando ele vem dos vizinhos (ACHEN; SHIVELY, 1995). Formalmente, a regressão observa apenas a soma de um termo individual e de um termo de contexto, e infinitos pares dos dois explicam os dados igualmente bem.
Problema de identificação da inferência ecológica (paráfrase de Achen e Shively, 1995). Com dados agregados, o modelo ya = B⊤xa + Γ g(xa) + ea, em que Γ g(·) representa o efeito de contexto, reproduz os totais igualmente bem para muitos pares (B, Γ). Toda estimativa de B depende de uma hipótese sobre o contexto, que os próprios agregados não permitem testar.
O modelo adotado ataca esse problema comparando apenas seções do mesmo local de votação, que compartilham o bairro e, portanto, o contexto.
Mínimos quadrados com restrições, covariáveis e encolhimento
A estimação parte de mínimos quadrados ponderados pelo eleitorado, dentro do conjunto de matrizes válidas. A suposição de matriz única é relaxada de duas formas. Primeiro, a matriz varia, dentro de cada estado, com o perfil do eleitorado da seção, medido pela fração com baixa escolaridade, pela fração com ensino superior e pela fração com 60 anos ou mais, dados que o TSE publica por seção. Com za o vetor dessas frações, centradas na média nacional,
em que u é o estado da seção. As linhas de B(0) somam 1 e as dos blocos de covariáveis somam 0, de modo que a matriz de cada seção continua com linhas somando 1, e a restrição de ficar entre 0 e 1 é imposta num conjunto de valores observados de z. Assim, se os brancos e nulos são mais comuns onde a escolaridade é baixa e Lula cresceu ali por outros motivos, o modelo consegue separar uma coisa da outra.
Em segundo lugar, cada estado tem a própria matriz, mas ela é puxada para a matriz nacional por uma penalidade quadrática, o equivalente a uma priori normal centrada na estimativa nacional (Bayes empírico):
Com o peso κ da ordem de 2 milhões de eleitores, São Paulo, com 34 milhões, quase não é afetado, enquanto estados pequenos ficam perto da média. O problema é uma programação quadrática convexa, com objetivo quadrático e restrições lineares. A consequência para a leitura dos resultados por estado é que as diferenças entre estados pequenos aparecem atenuadas.
Comparação dentro do local de votação e a restrição de totais
Um local de votação, que em cerca de 80% dos casos é uma escola, reúne várias seções que compartilham bairro, clima político e campanha local. O que muda entre elas é basicamente quais eleitores foram alocados a cada uma, por critérios administrativos. Comparando apenas seções do mesmo local, tudo que é comum ao local se cancela. É a lógica do efeito fixo em dados em painel, aplicada aqui ao local de votação. Com L(a) o local da seção a, pa = xa/Ea e qa = ya/Ea, e as médias de cada local ponderadas pelo eleitorado,
Um contexto constante no local, qa = B⊤pa + cL(a), desaparece na diferença. O custo é de identificação, já que as frações de cada seção somam 1 e, portanto, os desvios em relação à média do local somam zero. Somar a mesma constante a todas as linhas de uma coluna de B não altera o ajuste, de modo que as diferenças só revelam quanto cada grupo foi a mais ou a menos que os outros. O nível de cada coluna vem de uma restrição de igualdade, que obriga a matriz de cada estado a reproduzir o resultado do 2º turno no estado:
A hipótese embutida é que o efeito de contexto se cancela na média do estado, o que é a leitura natural de um deslocamento comum a todos os eleitores do estado. Locais com alguma seção cujo eleitorado mudou entre os turnos, por fusão ou remanejamento, ficam fora das diferenças, porque ali os eleitores do 1º e do 2º turno de uma seção não são os mesmos, e cerca de metade das seções está nessa situação. Como cada eleitor carrega menos informação na diferença dentro do local, o κ do encolhimento é reduzido na proporção entre os traços das duas matrizes de informação. A literatura de inferência ecológica trata o viés de contexto com covariáveis agregadas e modelos de vizinhança, mas não foi encontrada aplicação de efeito fixo de unidade com essa estrutura, de modo que a escolha deve ser lida como uma hipótese de modelagem que a validação por simulação testa diretamente.
Ajuste proporcional iterativo
A matriz estimada não reproduz exatamente os totais de cada seção. O passo final aplica o ajuste proporcional iterativo (IPF), que parte de Na,ij = Xa,i βa,ij, em número de eleitores, e alterna o ajuste das colunas aos totais do 2º turno e das linhas aos do 1º (DEMING; STEPHAN, 1940):
Após 60 iterações, cada tabela tem os totais oficiais da seção nos dois turnos, e os fluxos de um estado ou do país são somas de tabelas de seção, que conferem com o TSE. O IPF converge para a tabela que respeita as marginais e fica mais próxima, em divergência de Kullback-Leibler (uma medida de distância entre distribuições), do ponto de partida, e por isso o ponto de partida importa. Para que nenhuma célula comece em zero, cada taxa recebe um piso. Com piso de 0,1%, a validação mostrou que o ajuste espalhava eleitores demais para fluxos quase nulos e tirava a diferença dos fluxos de quem manteve o voto, um desvio sistemático que a reamostragem não enxerga. Com 0,01%, o desvio caiu cerca de um terço, e pisos menores não mudaram o resultado.

Incerteza, versões do modelo e calibração por simulação
A faixa de cada fluxo combina duas fontes de incerteza. A primeira é a amostragem. Como seções vizinhas se parecem, sortear seções isoladas subestimaria a variabilidade, e o bootstrap sorteia municípios inteiros, com reposição, dentro de cada estado (CAMERON; GELBACH; MILLER, 2008), refazendo o cálculo 400 vezes. O eleitorado de cada grupo de origem é conhecido exatamente, e só as taxas são incertas, por isso cada reamostragem é convertida em taxas e aplicada ao eleitorado real. Sem esse passo, a variação no tamanho das amostras (uma capital pode entrar zero ou duas vezes) alargaria a faixa dos fluxos grandes sem motivo.
A segunda fonte é a especificação. O mesmo cálculo é feito em cinco versões razoáveis do modelo, que diferem no agrupamento (estado com covariáveis, só estado, região, matriz nacional) e no nível de comparação (local ou zona eleitoral). Escolher uma versão e ignorar as demais subestima a incerteza (DRAPER, 1995), e a faixa bruta é o envelope que vai da menor estimativa entre as versões, menos a distância da principal até o seu percentil 5, à maior, mais a distância até o percentil 95.
Nenhuma dessas fontes garante que a faixa contém o valor verdadeiro, e a única forma de verificar é criar eleições em que a verdade é conhecida. Sobre a estrutura real de 146 mil seções de 2022, a validação sorteia a transição de cada seção, gera as contagens do 2º turno por sorteios multinomiais e roda exatamente o mesmo procedimento, em 96 eleições simuladas divididas em quatro cenários. O primeiro usa a transição estimada pelo próprio modelo (A). O segundo acrescenta desvios aleatórios por município e por seção na escala logit, o logaritmo da razão de chances (B). O cenário C introduz um efeito de contexto que muda de seção para seção dentro do mesmo local de votação, e o D, um efeito de contexto do local de votação inteiro, a forma realista do fenômeno.
A verificação é a mesma lógica do teste de cobertura de intervalos de previsão (CHRISTOFFERSEN, 1998), aplicada a fluxos em vez de retornos. O envelope bruto continha a verdade em apenas 69% dos fluxos relevantes nos cenários A e B, abaixo dos 90% pretendidos, porque os limites da matriz produzem desvios sistemáticos pequenos que se repetem em todas as reamostragens. A faixa publicada é, por isso, calibrada:
em que c multiplica a distância até cada ponta do envelope e d acrescenta uma fração do próprio fluxo, para cobrir o desvio dos fluxos grandes. Os dois parâmetros são os menores que levam a cobertura a 90% nos cenários A, B e D, ajustados nas eleições simuladas pares e conferidos nas ímpares, o que resultou em c = 1,5 e d = 0,8%, com cobertura de 92% nas eleições reservadas.

O cenário D confirma o papel da comparação dentro do local, já que o viés em brancos e nulos → Lula fica em 60 mil votos, enquanto a mesma especificação comparando seções da mesma zona erra 450 mil. No cenário C, quando o contexto muda de uma seção para outra dentro do mesmo local de votação, todas as versões superestimam esse fluxo em 1,1 milhão de votos, e nenhuma faixa cobre o erro. É uma situação pouco plausível, porque a divisão em seções é administrativa e o eleitor não sabe quem mais vota na sua seção, mas os dados não permitem descartá-la, razão pela qual os fluxos que saem de brancos e nulos nunca recebem a etiqueta de maior confiança na tabela de resultados.
Implementação em Julia
O modelo está implementado em Julia, linguagem de programação voltada à computação científica, no repositório pq_inferencia_ecologica, que reproduz desde o download dos arquivos do TSE até a validação por simulação. Cada estimação é um problema de programação quadrática convexa, com objetivo quadrático e restrições lineares, e (1 + K)·20 variáveis, em que K é o número de covariáveis. O problema é montado no JuMP, a biblioteca de modelagem de otimização do Julia, e resolvido pelo Clarabel, um otimizador de pontos interiores escrito na própria linguagem. As equações das seções anteriores correspondem uma a uma às restrições do código, de modo que o repositório pode ser lido junto com o texto.
Resultados para 2026
O diagrama e a tabela abaixo resumem os fluxos estimados para o Brasil. Os eleitores dos candidatos eliminados se dividiram quase ao meio entre os finalistas, enquanto Lula levou vantagem clara entre os abstencionistas do 1º turno e entre os eleitores de branco e nulo. As trocas diretas entre Lula e Flávio têm as faixas mais largas, de zero a cerca de 2 milhões nos dois sentidos.
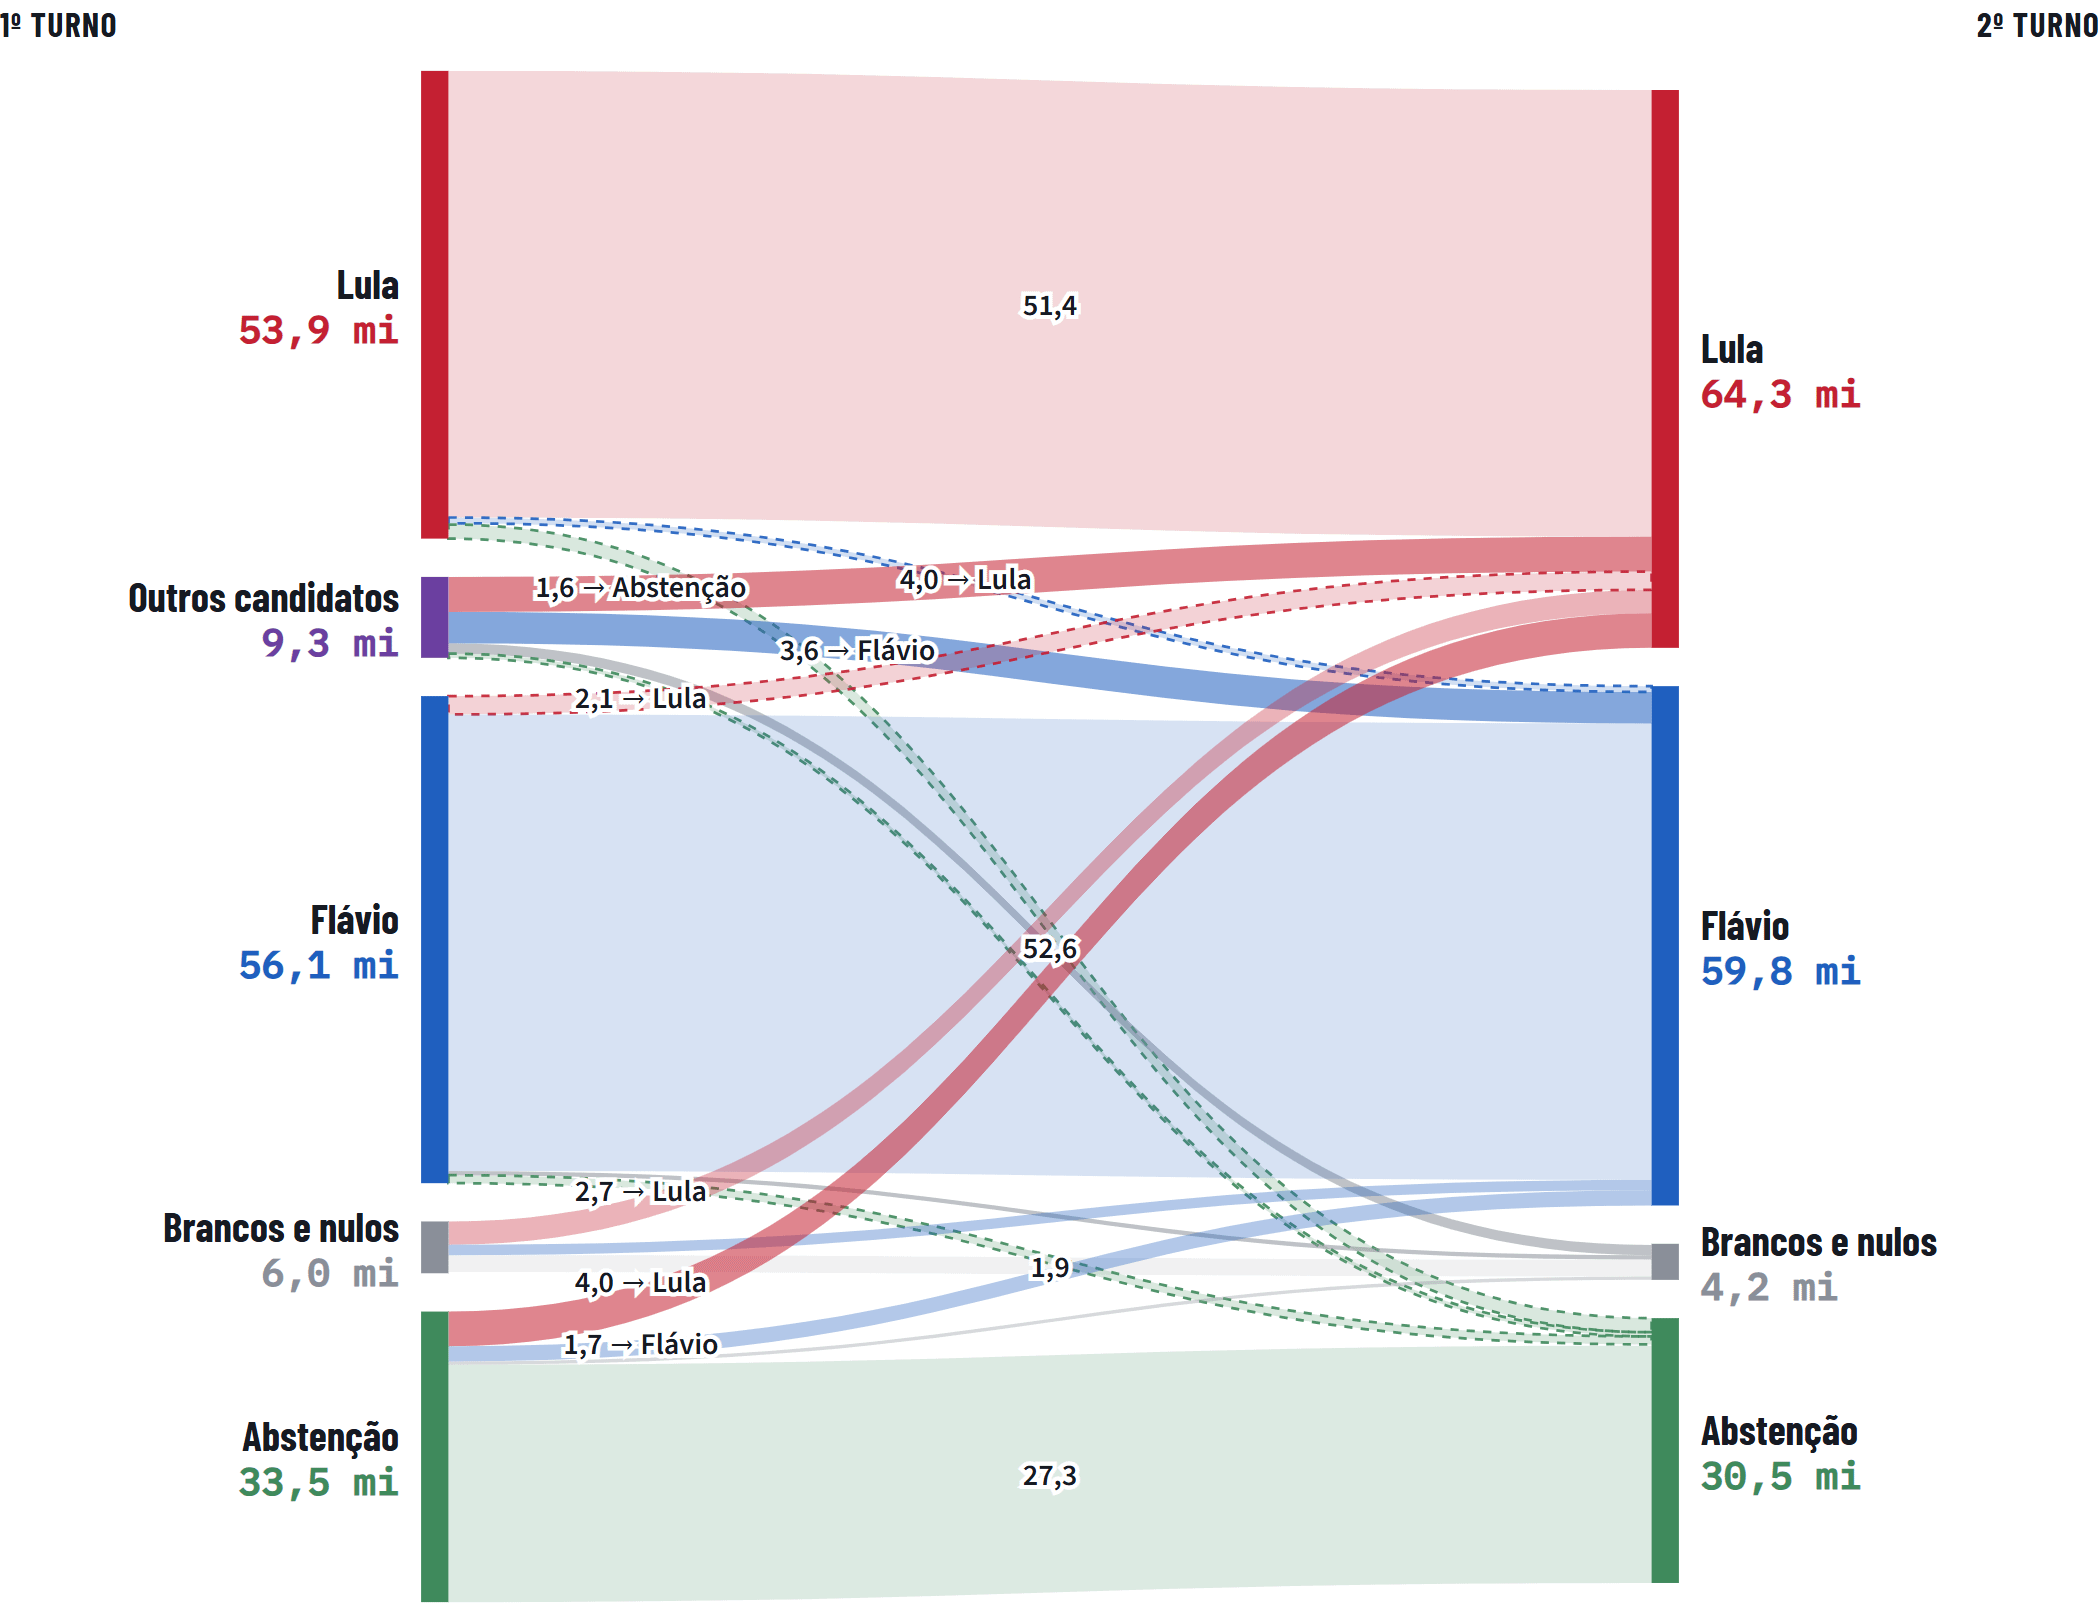
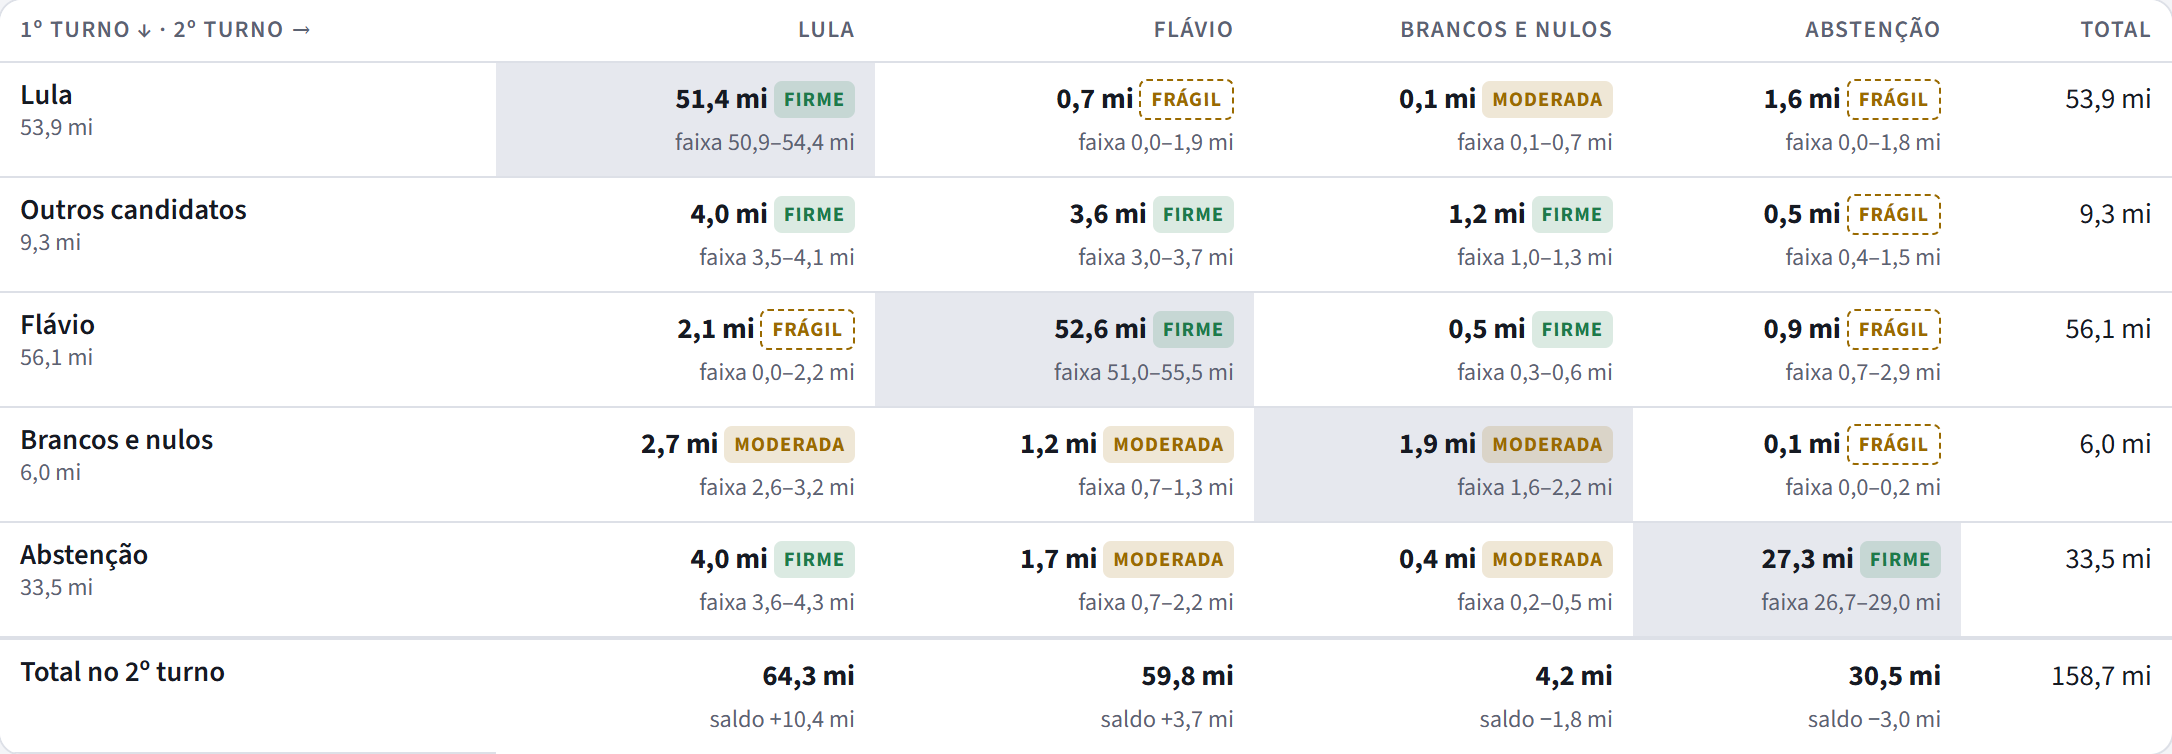
Decompondo a virada de 6,6 milhões de votos na diferença entre os candidatos, as trocas diretas respondem por cerca de 2,9 milhões, os abstencionistas que voltaram às urnas por 2,2 milhões, os eleitores de branco e nulo por 1,5 milhão e os eleitores dos eliminados por 0,4 milhão, descontados 0,4 milhão porque eleitores de Lula deixaram de votar ou anularam um pouco mais que os de Flávio. A maior parcela é também a menos determinada, e essa assimetria levou a uma mudança na forma de apresentar os resultados.
“Dois milhões foram de Flávio para Lula e setecentos mil fizeram o caminho inverso” explica os totais quase tão bem quanto um movimento muito menor nos dois sentidos, porque só o saldo altera as marginais. Em termos de identificação parcial (MANSKI, 2003), os dados restringem bem a diferença entre ida e volta e mal cada uma delas. Por isso a estimação calcula também o saldo de cada par de grupos, com faixa própria, montada com o bootstrap do próprio saldo e a mesma calibração. O saldo entre abstenção e Lula, de 2,4 milhões a favor de Lula, tem faixa de 2,0 a 5,1 milhões, e o saldo entre brancos e nulos e Lula, de 2,5 milhões, fica entre 2,3 e 3,0. Já o saldo das trocas diretas, estimado em 1,4 milhão a favor de Lula, tem faixa de 0,7 milhão a favor de Flávio a 1,7 milhão a favor de Lula, de modo que nem o sentido dessa troca está garantido.
Entre os estados, a divergência mais robusta está na volta dos abstencionistas. Na Bahia, em Pernambuco, no Ceará, na Paraíba, em Sergipe e no Rio Grande do Norte, entre 14% e 17% dos abstencionistas do 1º turno votaram em Lula no 2º, contra 4% a 7% no Acre, em Roraima e em Rondônia, com faixas que não incluem a taxa nacional de 12%. O Norte foi a única região em que a abstenção subiu entre os turnos, com altas de 8,1 pontos no Amapá, 6,0 em Roraima e 5,6 no Acre. A explicação usual, a ausência de 2º turno para governador, não se sustenta, porque o Acre teve disputa estadual e registrou uma das maiores altas.
Onde a mesma estrutura aparece em finanças quantitativas
A regressão de Goodman é um caso particular de um problema que finanças quantitativas enfrentam com frequência, que é estimar uma matriz de transição a partir de marginais. O paralelo mais direto é a cadeia de Markov observada só por proporções agregadas. Se πt é o vetor com as frações de uma carteira em cada estado no período t e P a matriz de transição, então πt+1 = P⊤πt + εt, com linhas de P somando 1 e elementos não negativos, a mesma estrutura da equação dos turnos com o tempo no lugar das seções. A estimação por mínimos quadrados restritos dessa equação remonta a Lee, Judge e Zellner (1970), e ten Cate (2018) mostra que o modelo de Markov com macrodados e o modelo de inferência ecológica compartilham a mesma verossimilhança.
Em risco de crédito, a aplicação aparece quando as trajetórias individuais não estão disponíveis. Jones (2005) estima matrizes de transição de crédito nos Estados Unidos a partir de proporções agregadas, como a de empréstimos inadimplentes, condicionando a matriz ao ciclo econômico, e a ideia de deixar a matriz variar com variáveis macroeconômicas é a mesma da migração de rating condicionada ao regime de Bangia et al. (2002). No modelo eleitoral, o papel do ciclo é feito pelas covariáveis de escolaridade e idade. Carteiras de varejo em que só se observam os saldos por faixa de atraso, como as que alimentam estimativas de perda esperada e o estagiamento contábil (a classificação dos créditos em estágios de risco da norma IFRS 9), enfrentam o mesmo dilema de identificação, já que a migração bruta entre faixas não se separa da migração líquida sem hipóteses adicionais.
Em estabilidade financeira, quando um supervisor conhece apenas o total de ativos e de passivos interbancários de cada banco, a matriz de exposições bilaterais é estimada por máxima entropia, com o algoritmo RAS (o nome vem da notação r·A·s, em que a matriz A é multiplicada por fatores de linha r e de coluna s), que é o IPF aplicado a matrizes (UPPER; WORMS, 2004). Mistrulli (2011), comparando com exposições observadas no mercado italiano, mostra que a máxima entropia, ao supor uma rede completa, em que todos os bancos se expõem a todos, tende a superestimar o contágio, dependendo da estrutura da rede e das hipóteses de perda. O piso do IPF no modelo eleitoral produz o mesmo tipo de viés, porque o ponto de partida uniforme espalha massa para células que deveriam ser quase nulas, e nos dois casos o desvio só aparece quando se compara com uma verdade conhecida.
Nos fundos de investimento, a captação líquida, calculada como variação do patrimônio menos o retorno, é o análogo do saldo entre dois grupos de eleitores, e a captação e o resgate brutos são o análogo da ida e da volta. Cashman et al. (2012) mostram que captação e resgate reagem de forma assimétrica ao desempenho e que essa assimetria some no fluxo líquido, o que reforça a cautela de interpretar fluxos brutos estimados a partir de totais líquidos, seja de fundos, de clientes entre instituições ou de eleitores entre candidatos.
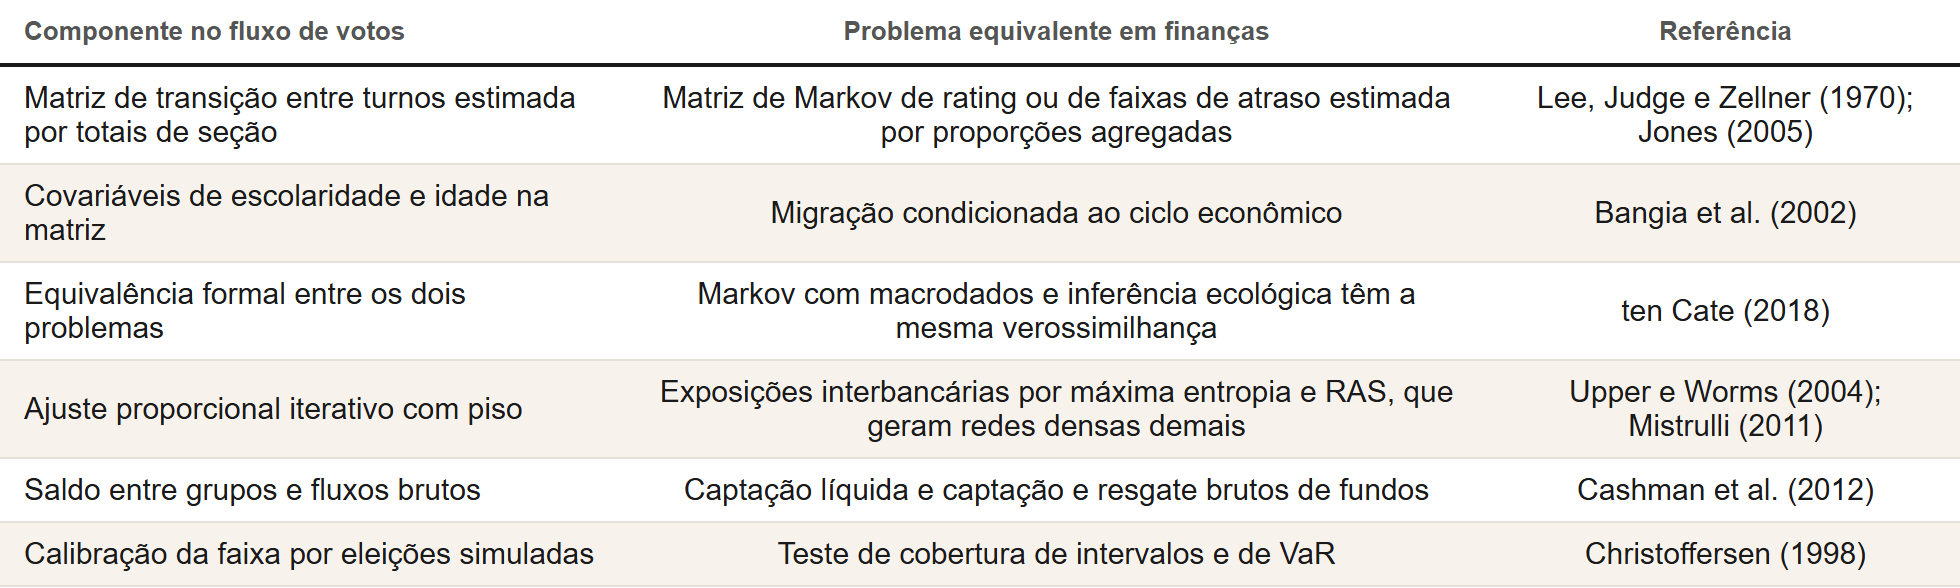
Verificar se um intervalo de 90% contém a verdade em 90% das eleições simuladas é o mesmo exercício de um teste de cobertura do valor em risco (VaR), com a vantagem de que a simulação permite conhecer a verdade e testar cenários específicos de falha do modelo. A tabela abaixo resume as correspondências.
Conclusão
Com 500 mil unidades, comparação dentro do local e faixas calibradas, os movimentos que alteram as marginais (abstencionistas que voltaram, brancos e nulos que escolheram um lado, eleitores dos eliminados que se dividiram) ficam bem determinados. A divisão de um saldo em ida e volta depende de hipóteses que os dados não testam, e a validação por simulação mostrou que mesmo a faixa mais cuidadosa falha quando o contexto varia dentro da unidade de comparação.
Para quem estima matrizes de migração de crédito, exposições interbancárias ou fluxos brutos de fundos a partir de totais, a lição transfere sem adaptação. A identificação do efeito de contexto precisa de uma escolha explícita de comparação, o ponto de partida do IPF ou da máxima entropia introduz viés nas células quase nulas, os saldos merecem mais confiança que os fluxos brutos, e a cobertura das faixas só é conhecida depois de testada contra uma verdade simulada que inclua os cenários em que o modelo pode falhar.
Referências
ACHEN, C. H.; SHIVELY, W. P. Cross-level inference. Chicago: University of Chicago Press, 1995.
BANGIA, A.; DIEBOLD, F. X.; KRONIMUS, A.; SCHAGEN, C.; SCHUERMANN, T. Ratings migration and the business cycle, with application to credit portfolio stress testing. Journal of Banking & Finance, v. 26, n. 2-3, p. 445-474, 2002.
CAMERON, A. C.; GELBACH, J. B.; MILLER, D. L. Bootstrap-based improvements for inference with clustered errors. The Review of Economics and Statistics, v. 90, n. 3, p. 414-427, 2008.
CASHMAN, G. D.; DELI, D. N.; NARDARI, F.; VILLUPURAM, S. Investors do respond to poor mutual fund performance: evidence from inflows and outflows. The Financial Review, v. 47, n. 4, p. 719-739, 2012.
CHRISTOFFERSEN, P. F. Evaluating interval forecasts. International Economic Review, v. 39, n. 4, p. 841-862, 1998.
DEMING, W. E.; STEPHAN, F. F. On a least squares adjustment of a sampled frequency table when the expected marginal totals are known. The Annals of Mathematical Statistics, v. 11, n. 4, p. 427-444, 1940.
DRAPER, D. Assessment and propagation of model uncertainty. Journal of the Royal Statistical Society: Series B (Methodological), v. 57, n. 1, p. 45-97, 1995.
GOODMAN, L. A. Ecological regressions and behavior of individuals. American Sociological Review, v. 18, n. 6, p. 663-664, 1953.
JONES, M. T. Estimating Markov transition matrices using proportions data: an application to credit risk. Washington, DC: International Monetary Fund, 2005. (IMF Working Paper, WP/05/219).
LEE, T. C.; JUDGE, G. G.; ZELLNER, A. Estimating the parameters of the Markov probability model from aggregate time series data. Amsterdam: North-Holland, 1970. (Contributions to Economic Analysis, 65).
MANSKI, C. F. Partial identification of probability distributions. New York: Springer, 2003.
MISTRULLI, P. E. Assessing financial contagion in the interbank market: maximum entropy versus observed interbank lending patterns. Journal of Banking & Finance, v. 35, n. 5, p. 1114-1127, 2011.
TEN CATE, A. Maximum likelihood estimation of the Markov chain model with macro data and the ecological inference model. Journal of Economic and Social Measurement, v. 43, n. 1-2, p. 1-9, 2018.
UPPER, C.; WORMS, A. Estimating bilateral exposures in the German interbank market: is there a danger of contagion? European Economic Review, v. 48, n. 4, p. 827-849, 2004.